MariaDB-Kurs / Replikation, Verzögerungen, Fehler und Serverwechsel verstehen
Die gewöhnliche asynchrone MariaDB-Replikation überträgt Änderungen eines Primärservers zu einem Replikat, das sie auf seine Daten anwendet. Ein vorhandenes Replikat garantiert weder einen aktuellen Datenstand noch einen automatischen Serverwechsel. Betrachten Sie Verzögerung, Fehler, möglichen Datenverlust und den Schreibweg der Anwendung gemeinsam.
Eine Änderung vom Primärserver zum Replikat verfolgen
Der Primärserver schreibt Änderungen in sein Binärprotokoll. Der Empfangsthread des Replikats übernimmt sie in ein Relay Log, ein zwischengespeichertes Übertragungsprotokoll. Anschließend wendet die Verarbeitung sie auf die Replikatdaten an. Parallele Replikation kann mehrere Arbeiter verwenden; Empfang und Anwendung bleiben dennoch unterschiedliche Schritte.
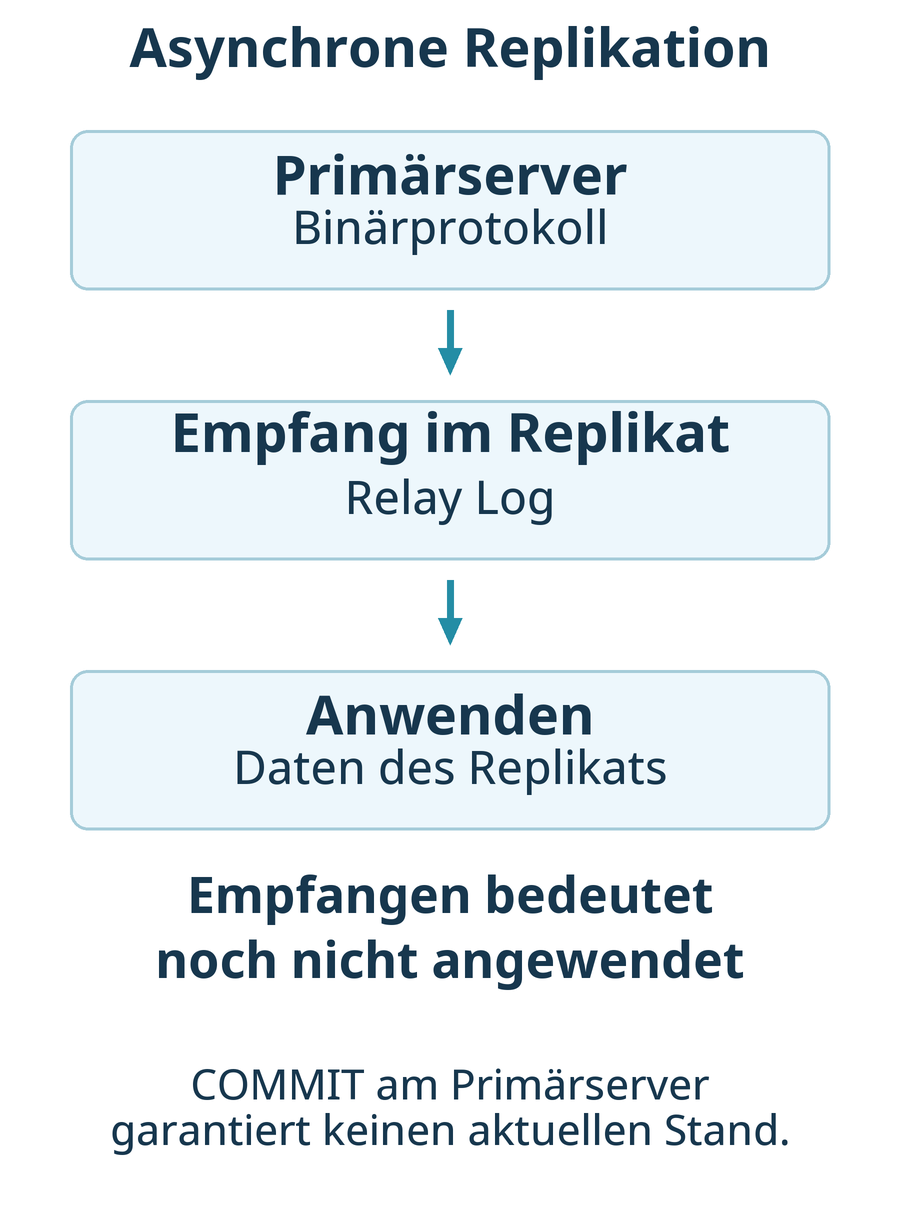
Ein erfolgreiches COMMIT am Primärserver bedeutet nicht, dass ein asynchrones Replikat die Transaktion bereits angewendet hat. Eine unmittelbar folgende Leseabfrage dort kann einen früheren Wert liefern. Benötigt eine Anfrage den soeben geschriebenen Zustand, ist eine ausdrückliche Routingregel erforderlich. Die offiziellen Referenzen zur Replikationseinrichtung und zu MariaDB-GTIDs erklären Protokolle und Positionen.
GTID steht für Global Transaction ID, eine globale Transaktionskennung zur Positionsverfolgung. Eine vorhandene GTID validiert Daten nicht automatisch und macht ein Replikat nicht von selbst zum geeigneten Primärserver. MariaDB und MySQL verwenden unterschiedliche GTID-Implementierungen; derselbe Begriff bedeutet keine kompatible Syntax oder Funktionsweise.
Zwei neue Server für die erste Übung vorbereiten
Überspringen Sie diesen Aufbau, wenn bereits ein korrekt eingerichtetes Lernreplikat besteht. Verwenden Sie andernfalls ein neues Projekt mit leeren Volumes, keine Produktionsserver oder vorhandene Replikate. Der Aufbau folgt den Passwortdateien der MariaDB-Lernumgebung mit Docker Compose.
Erstellen Sie in einem neuen Ordner secrets/primary-root.txt und secrets/replica-root.txt mit je einem unterschiedlichen root-Passwort in einer Zeile. Schließen Sie secrets/ von der Versionsverwaltung aus und schützen Sie den lokalen Dateizugriff. Speichern Sie Folgendes als compose.yaml. Es werden keine Hostports veröffentlicht; die Server kommunizieren im internen Compose-Netz. mariadb:11.8 bezeichnet eine Wartungsfamilie. Halten Sie für exakte Reproduzierbarkeit einen freigegebenen Digest fest.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
Prüfen Sie die Verfügbarkeit von Docker und Compose und führen Sie die Befehle im neuen Projektordner aus. Ist der Projektname schon belegt, wählen Sie vor dem Start einen anderen, um dessen Volumes nicht wiederzuverwenden.
docker compose config --quiet
docker compose up -d
docker compose ps
Warten Sie auf healthy bei beiden Diensten. Konfigurieren Sie die Replikation vor dem Einfügen von Anwendungsdaten. Öffnen Sie zuerst den lokalen Verwaltungsclient des Primärservers:
docker compose exec primary mariadb -u root -pGeben Sie das Passwort aus primary-root.txt ein und ersetzen Sie das öffentliche Demonstrationspasswort vor der Ausführung:
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
Die letzte Zeile \q beendet den Client; sie ist ein Clientbefehl und kein Server-SQL. Das Hostmuster % vergibt für sich keine Verwaltungsrechte. Hier wird ausschließlich Replikationszugriff im getrennten Übungsnetz ohne veröffentlichte Ports vergeben. Eine entfernte Installation benötigt passende Herkunftsbeschränkungen und Transport Layer Security (TLS), die Verschlüsselung der Verbindung. Übernehmen Sie den Übungsumfang nicht pauschal in ein gemeinsam genutztes Netz.
Öffnen Sie danach den Verwaltungsclient des Replikats und geben Sie das Passwort aus replica-root.txt ein:
docker compose exec replica mariadb -u root -pTragen Sie dort dasselbe neue Replikationspasswort wie am Primärserver ein. Veröffentlichen Sie keine Befehle oder Ausgaben mit echten Geheimnissen.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
Der Aufbau setzt zwei neue leere Server und noch verfügbare Primärprotokolle voraus. Bei vorhandenen Daten oder fehlenden Protokollen benötigen Sie zuerst einen konsistenten Anfangsbestand mit passender Position. Verbindungskoordinaten gleichen unterschiedliche Daten nicht ab. Prüfen Sie Yes bei beiden Threads, bevor Sie fortfahren.
Prüfen Sie die Docker-Konfiguration in Ihrer Umgebung anhand von Zuständen und Containerprotokollen. Die nachfolgenden Übertragungs- und Pausenversuche wurden mit zwei temporären nativen MariaDB-12.3.3-Servern, verschiedenen Serverkennungen, ROW-Binärprotokoll und GTID überprüft. Das ist kein Ausführungstest des Docker-Images oder einer entfernten TLS-Verbindung.
Topologie und Diagnoserechte bestätigen
Die folgenden Abfragen untersuchen eine bereits eingerichtete Topologie. Diese benötigt unterschiedliche server_id-Werte, Binärprotokoll am Primärserver, Replikationskonto, Netzwerkweg und einen konsistenten Anfangsbestand. Statusabfragen benötigen versionsgerechte Rechte wie REPLICA MONITOR. Diese unterscheiden sich von den Rechten zur Threadsteuerung. Eine Anwendung benötigt für betriebliches Monitoring nicht automatisch vollständige Verwaltungsrechte.
Prüfen Sie am Primärserver Identität und Binärprotokoll und halten Sie die Position fest:
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
Führen Sie am Replikat Folgendes aus:
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
Seit MariaDB 12.0 ist read_only eine Aufzählung, die auch NO_LOCK und NO_LOCK_NO_ADMIN kennt. Interpretieren Sie den Wert versionsbezogen, statt stets numerisch 0 oder 1 zu erwarten. Die read_only-Referenz beschreibt die Modi.
\G ist ein Clientabschluss für vertikale Ausgabe im mariadb-Kommandozeilenclient. Eine SQL-Schnittstelle sendet ihn nicht unverändert mit: Der Treiber übermittelt die SQL-Anweisung und liest ihre Ergebnisspalten.
Zusammengehörige Statusfelder gemeinsam lesen
| Feld | Bedeutung |
|---|---|
| Slave_IO_Running | Empfangszustand; Yes allein belegt keine angewendeten Daten |
| Slave_SQL_Running | Anwendungszustand; bewusste Pause von Fehler unterscheiden |
| Last_IO_Error und Last_SQL_Error | Hinweise für Transport- oder Anmeldefehler gegenüber Verarbeitungsfehlern |
| Seconds_Behind_Master | Zustands- und zeitabhängiger Verzögerungswert; weder 0 noch NULL belegen allein Funktionsfähigkeit |
| Gtid_IO_Pos und @@GLOBAL.gtid_slave_pos | Empfangene und angewendete Positionen im Kontext von Domänen und Topologie |
Auch bei SHOW REPLICA STATUS können historische Spaltennamen mit Slave und Master erscheinen. Ihre Reihenfolge kann versionsabhängig sein. Monitoring sollte Feldnamen statt fester numerischer Positionen verwenden. Die SHOW-REPLICA-STATUS-Referenz erläutert die Felder.
Laufende Threads, die Ankunft einer bestimmten Geschäftsänderung und ein akzeptabler Verlust bei einem Ausfall sind getrennte Prüfungen. Halten Sie Zustände und Positionen fest und gleichen Sie benötigte Daten oder Verarbeitungsmarker ab. Ein kleiner Verzögerungswert schließt Abweichungen durch Filter oder unbeabsichtigte lokale Schreibzugriffe nicht aus.
Eine Verarbeitungspause im getrennten Labor beobachten
Führen Sie diesen Versuch ausschließlich in einer getrennten entbehrlichen Replikationsumgebung mit Threadsteuerungsrechten durch. Es ist kein Ablauf zum Anhalten eines Produktionsreplikats während der Diagnose. Erstellen Sie am Primärserver die Testtabelle. Prüfen Sie ein vorhandenes Objekt dieses Namens vor CREATE:
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
Wiederholen Sie auf dem Replikat folgende Abfrage, bis die erste Zeile erscheint. Prüfen Sie Zustand und Fehler, wenn sie ausbleibt:
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;before-pause bedeutet „vor der Pause“. Halten Sie am Replikat nur den Anwendungsthread an. Der Empfang kann weiterlaufen und verdeutlicht so den Unterschied zwischen empfangenen Protokollen und sichtbaren Daten.
STOP REPLICA SQL_THREAD;Fügen Sie am Primärserver die zweite Zeile ein. during-pause bedeutet „während der Pause“:
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');Die Replikatabfrage soll weiterhin nur die erste Zeile zeigen. Prüfen Sie mit SHOW REPLICA STATUS zusätzlich laufenden Empfang und gestoppte Anwendung. Setzen Sie nach der Beobachtung die Anwendung am Replikat fort:
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
Ohne verhindernde Filter oder Fehler soll die zweite Zeile ankommen. Die Anwendung benötigt Zeit; eine einzelne sofortige Abfrage ohne die Zeile belegt noch keinen endgültigen Fehler. Warten Sie umgekehrt nicht unbegrenzt ohne Status- und Fehlerprüfung. Übernehmen Sie keinen Startbefehl in eine Umgebung, deren Replikation für eine andere Aufgabe bewusst angehalten wurde.
Bestätigen Sie den ursprünglichen laufenden Zustand. Entfernen Sie die entbehrliche Testtabelle danach am Primärserver mit DROP TABLE replication_lab.probe; und prüfen Sie ihr Verschwinden am Replikat. Entfernen Sie keine Geschäftsobjekte und setzen Sie keine Replikationskonfiguration zur Bereinigung dieser Tabelle zurück.
Vor dem Überspringen oder Zurücksetzen Belege erhalten
| Problem | Zuerst untersuchen | Voreilige Reaktion vermeiden |
|---|---|---|
| Empfänger verbindet sich nicht | Adresse, Port, Namensauflösung, Firewall, TLS, Konto und letzter IO-Fehler | Authentifizierung oder Verschlüsselung abschalten |
| Anwendung stoppt | Doppelte Schlüssel, fehlende Zeilen, Strukturunterschiede, Filter und letzter SQL-Fehler | Ereignis ohne Verständnis der Datenwirkung überspringen |
| Benötigtes Protokoll fehlt | Aufbewahrung, Replikatposition und konsistenter Anfangsbestand | Position ohne passenden Datenbestand erzwingen |
| Verzögerung wächst | Schreibaufkommen, Ein- und Ausgabe, Prozessorlast, große Transaktionen und Sperren | Primärrolle anhand eines einzelnen Messwerts vergeben |
Sichern Sie zuerst Zustände und Fehler mit Zeitangaben. Bei Abweichungen kann ein Neuaufbau aus einer konsistenten Sicherung nötig sein. Das Überspringen eines Ereignisses kann Threads wieder starten und trotzdem fehlende oder widersprüchliche Daten hinterlassen. Replikation kann auch ein fehlerhaftes DELETE weitergeben. Sie ersetzt deshalb weder unabhängige Sicherungen noch eine geprüfte Wiederherstellung.
Den Serverwechsel als Kontrolle des Schreibwegs behandeln
- Stellen Sie den Ausfall fest und isolieren Sie den bisherigen Primärserver von neuen Schreibzugriffen. Eine Netztrennung allein beweist nicht, dass er keine Änderungen mehr annimmt.
- Prüfen Sie bei Kandidaten empfangene und angewendete Positionen, ausstehende Arbeit, Fehler und möglichen Verlust.
- Bewerten Sie das Recovery Point Objective (RPO), den zulässigen Datenverlust, und das Recovery Time Objective (RTO), die zulässige Wiederherstellungszeit.
- Folgen Sie dem freigegebenen Rollen- und Routingverfahren, um genau ein Schreibziel festzulegen. Prüfen Sie danach Lese- und Schreibzugriffe der Anwendung.
- Prüfen Sie vor der Rückkehr des alten Primärservers dessen Konsistenz und bauen Sie ihn bei Bedarf als Replikat neu auf.
Im verwendeten ON-Modus begrenzt read_only gewöhnliche Schreibzugriffe; es ist keine absolute Sperre gegen sämtliche privilegierten Änderungen. Beachten Sie die Rechteausnahmen schreibgeschützter Replikate. Das Abschalten von read_only ist kein vollständiges Verfahren zum Primärserverwechsel. Split Brain, also zwei gleichzeitig schreibende Server, wird nur durch abgestimmte Isolation des bisherigen Primärservers und Kontrolle von Routing und Verbindungen vermieden.