Curso de MariaDB / Entender la replicación, el retraso, los errores y la conmutación
La replicación asíncrona estándar de MariaDB transmite los cambios de un servidor principal a una réplica, que los aplica a sus datos. Tener una réplica no garantiza que esté al día ni que la conmutación ante fallos sea automática: gestione juntos el retraso, los errores, la posible pérdida de datos y la ruta de escritura de la aplicación.
Seguir un cambio del principal a la réplica
El principal escribe los cambios en su registro binario. El hilo receptor de la réplica recoge esos registros en un registro de retransmisión, o relay log; el mecanismo de aplicación los procesa después sobre los datos de la réplica. La replicación paralela puede emplear varios trabajadores, pero recibir y aplicar siguen siendo etapas distintas.
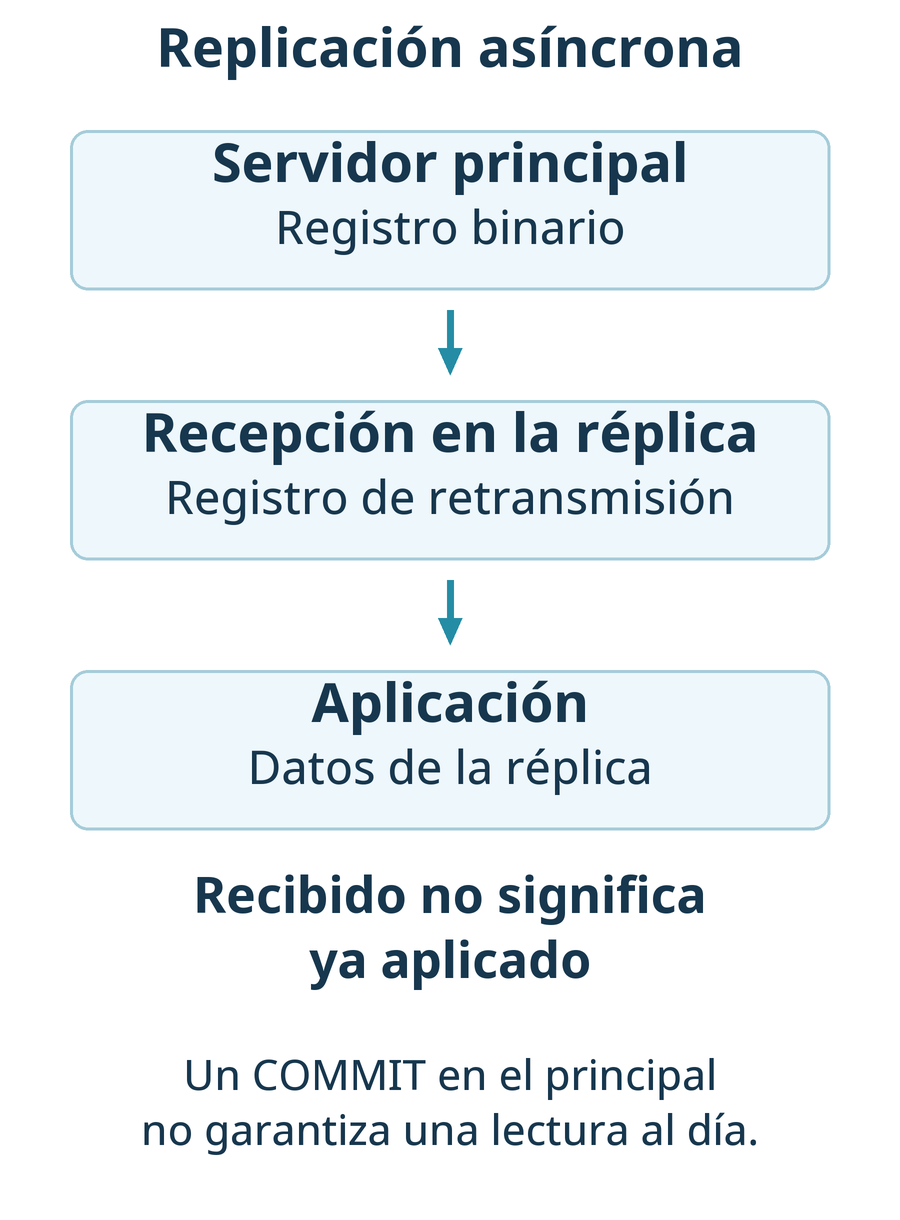
Un COMMIT correcto en el principal no significa que una réplica asíncrona haya terminado de aplicar la transacción. Leer la réplica inmediatamente después de escribir puede devolver un valor anterior. Las solicitudes que requieren leer lo recién escrito necesitan una política explícita de enrutamiento. Las referencias de configuración de la replicación y GTID de MariaDB explican registros y posiciones.
GTID significa Global Transaction ID, identificador global de transacción, y permite seguir posiciones de replicación. Su presencia no valida automáticamente los datos ni hace que toda réplica esté lista para ser principal. MariaDB y MySQL tienen implementaciones GTID diferentes; compartir el nombre no implica compatibilidad de sintaxis o comportamiento.
Preparar dos servidores nuevos para la primera práctica
Omita esta preparación si ya dispone de una réplica de aprendizaje correctamente configurada. Para la primera práctica, use un proyecto nuevo con volúmenes vacíos, nunca servidores de producción o una réplica preexistente. Se utiliza el enfoque de archivos secretos del entorno MariaDB con Docker Compose.
En una carpeta nueva, cree secrets/primary-root.txt y secrets/replica-root.txt, cada uno con una contraseña root distinta en una sola línea. Excluya secrets/ del control de versiones y proteja los archivos locales. Guarde lo siguiente como compose.yaml. No se publican puertos del host: los servidores se comunican en una red interna de Compose. La etiqueta mariadb:11.8 sigue una familia de versiones correctivas; registre un digest aprobado si necesita reproducir una imagen exacta.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
Compruebe que Docker y Compose están disponibles y ejecute desde esa carpeta. Si el nombre del proyecto ya está en uso, elija otro antes de iniciar para evitar reutilizar sus volúmenes.
docker compose config --quiet
docker compose up -d
docker compose ps
Espere a que ambos servicios estén healthy, es decir, superen su comprobación de estado. Configure la replicación antes de insertar datos de aplicación. Abra primero el cliente administrador local del principal:
docker compose exec primary mariadb -u root -pIntroduzca la contraseña de primary-root.txt y sustituya la contraseña pública de demostración por otra propia antes de ejecutar:
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
La última línea \q sale del cliente; es una orden del cliente, no SQL del servidor. El patrón de host % no concede por sí mismo derechos de administrador: aquí solo se concede replicación dentro de una red de prácticas sin puertos publicados. Un despliegue remoto requiere restringir el origen y establecer TLS. No traslade directamente este alcance de laboratorio a una red compartida.
Abra después el cliente administrador de la réplica e introduzca la contraseña de replica-root.txt:
docker compose exec replica mariadb -u root -pEn esa conexión, proporcione la misma contraseña nueva de replicación utilizada en el principal. No publique comandos o salidas con secretos reales.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
Esta inicialización supone dos servidores nuevos y vacíos y registros necesarios todavía disponibles en el principal. Si ya hay datos o faltan registros, prepare primero una copia inicial coherente y su posición correspondiente. Las coordenadas de conexión no reconcilian datos divergentes. Compruebe que ambos hilos indiquen Yes antes de continuar.
La configuración Docker debe verificarse en su entorno mediante los estados y registros de los contenedores. Los ejercicios de transferencia y pausa siguientes se comprobaron con dos servidores nativos temporales MariaDB 12.3.3, con identificadores distintos, registro binario ROW y GTID. Esto no constituye una prueba de inicio de la imagen Docker ni de TLS remoto.
Confirmar la topología y los permisos de diagnóstico
Las consultas siguientes inspeccionan una topología ya configurada. Requiere server_id diferentes, registro binario del principal, cuenta de replicación, ruta de red y datos inicialmente coherentes. Inspeccionar el estado exige los permisos apropiados para la versión, por ejemplo REPLICA MONITOR, distintos de los que permiten detener hilos. Una aplicación no necesita acceso de administrador completo para permitir supervisión operativa.
En el principal, confirme identidad y registro binario y anote la posición:
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
En la réplica, ejecute:
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
Desde MariaDB 12.0, read_only es una enumeración que también ofrece NO_LOCK y NO_LOCK_NO_ADMIN. Interprete el resultado según la versión en lugar de exigir siempre un 0 o 1 numérico. La referencia de read_only describe sus modos.
\G es un terminador de salida vertical del cliente de línea de comandos mariadb. No se envía tal cual mediante una API SQL: un controlador transmite la instrucción SQL y lee sus columnas de resultado.
Interpretar los campos de estado en conjunto
| Campo | Interpretación |
|---|---|
| Slave_IO_Running | Estado de recepción; Yes por sí solo no demuestra que los datos se hayan aplicado |
| Slave_SQL_Running | Estado de aplicación; distinga una pausa voluntaria de un error |
| Last_IO_Error y Last_SQL_Error | Indicios para separar fallos de transporte o autenticación de fallos al aplicar |
| Seconds_Behind_Master | Indicador dependiente del estado y momento; ni 0 ni NULL demuestran por sí solos un estado correcto |
| Gtid_IO_Pos y @@GLOBAL.gtid_slave_pos | Posiciones recibida y aplicada, interpretadas según dominios y topología |
Aunque el comando sea SHOW REPLICA STATUS, las columnas pueden conservar los nombres históricos Slave y Master. El orden también puede variar entre versiones: un programa de supervisión debe leer los campos por nombre en lugar de posiciones numéricas fijas. La referencia SHOW REPLICA STATUS describe los campos.
Que ambos hilos estén activos, que llegue una escritura concreta y que la pérdida potencial ante un fallo sea aceptable son comprobaciones diferentes. Anote estados y posiciones y concilie los datos o marcadores de negocio necesarios. Un retraso pequeño no descarta divergencias causadas por filtros o escrituras involuntarias en la réplica.
Observar una pausa de aplicación en el laboratorio
Hágalo solo en una topología separada y prescindible, con permisos de control de hilos. No es un procedimiento para detener una réplica de producción mientras diagnostica. En el principal, cree la tabla de prueba; si el nombre ya existe, examínelo antes de repetir CREATE:
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
En la réplica, repita esta lectura hasta observar la primera fila o revise el estado y los errores si no llega:
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;El marcador before-pause significa antes de la pausa. En la réplica, detenga únicamente el hilo de aplicación. El receptor puede continuar recogiendo registros, lo que permite distinguir los registros recibidos de los datos visibles.
STOP REPLICA SQL_THREAD;En el principal, añada la segunda fila, cuyo marcador during-pause significa durante la pausa:
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');La consulta en la réplica debe mostrar todavía solo la primera fila. Revise también SHOW REPLICA STATUS para observar la recepción activa y la aplicación detenida. Tras comprobar esa diferencia, reanude la aplicación en la réplica:
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
Sin filtros ni errores que lo impidan, debe llegar la segunda fila. Aplicar requiere tiempo: una única lectura inmediata sin esa fila no demuestra un fallo definitivo. Tampoco espere indefinidamente sin revisar estado y último error. No copie una orden de reanudación en un entorno cuya replicación estuviera detenida por otra operación.
Confirme el regreso al estado activo inicial. Cuando ya no necesite la prueba, elimine su tabla desde el principal con DROP TABLE replication_lab.probe; y confirme su desaparición en la réplica. No elimine objetos de negocio ni reinicialice la configuración de replicación para retirar esta tabla.
Conservar pruebas antes de saltar o reinicializar eventos
| Problema | Qué investigar primero | Respuesta prematura que evitar |
|---|---|---|
| El receptor no conecta | Dirección, puerto, DNS, cortafuegos, TLS, cuenta y último error IO | Desactivar autenticación o cifrado |
| Se detiene la aplicación | Claves duplicadas, filas ausentes, diferencias de esquema, filtros y último error SQL | Saltar un evento sin entender su efecto sobre los datos |
| Falta el registro necesario | Retención del principal, posición de la réplica y coherencia de la copia inicial | Forzar una posición sin datos coherentes que le correspondan |
| El retraso aumenta | Escrituras, entrada/salida y CPU de la réplica, transacciones grandes y bloqueos | Promover un servidor basándose en un solo indicador |
Conserve primero estados y errores con fecha y hora. Ante divergencias, considere reconstruir la réplica desde una copia coherente. Saltar un evento puede reactivar los hilos dejando datos ausentes o inconsistentes. La replicación también puede propagar un DELETE erróneo; no sustituye las copias de seguridad independientes ni la verificación de restauración.
Tratar la conmutación como control de la ruta de escritura
- Determine el fallo y aísle al principal anterior de nuevas escrituras. Una partición de red no demuestra por sí sola que haya dejado de aceptarlas.
- Examine posiciones recibidas y aplicadas de las réplicas candidatas, trabajo pendiente, errores y pérdida potencial.
- Evalúe el RPO, Recovery Point Objective u objetivo de punto de recuperación, que expresa la pérdida aceptable, y el RTO, Recovery Time Objective u objetivo de tiempo de recuperación, que expresa el plazo aceptable para restablecer el servicio.
- Siga el procedimiento aprobado de promoción y enrutamiento para establecer un único destino de escritura y compruebe las lecturas y escrituras de la aplicación.
- Antes de reincorporar el antiguo principal recuperado, compruebe coherencia y reconstruya ese servidor como réplica si es necesario.
En el modo ON del ejemplo, read_only limita las escrituras de usuarios ordinarios; no bloquea absolutamente toda escritura privilegiada. Consulte las excepciones de permisos de las réplicas de solo lectura. Desactivar read_only no constituye un procedimiento completo de promoción. Evitar el split brain, donde dos servidores aceptan escrituras simultáneamente, exige aislar el principal anterior y controlar juntos el enrutamiento y las conexiones.