Kursus MariaDB / Memahami Replikasi, Keterlambatan, Kesalahan, dan Failover
Replikasi asinkron standar MariaDB memindahkan catatan perubahan dari server utama ke replika, lalu menerapkannya pada data replika. Adanya replika tidak menjamin data sudah mutakhir atau perpindahan server terjadi otomatis. Kelola keterlambatan, kesalahan, kemungkinan kehilangan data, dan jalur penulisan aplikasi sebagai satu kesatuan.
Ikuti perubahan dari server utama ke replika
Server utama mencatat perubahan dalam binary log. Thread penerima replika mengambil catatan tersebut ke relay log, yaitu log perantara penerimaan. Selanjutnya, thread penerap menjalankannya pada data replika. Replikasi paralel dapat memakai beberapa pekerja, tetapi menerima dan menerapkan perubahan tetap merupakan tahap yang berbeda.
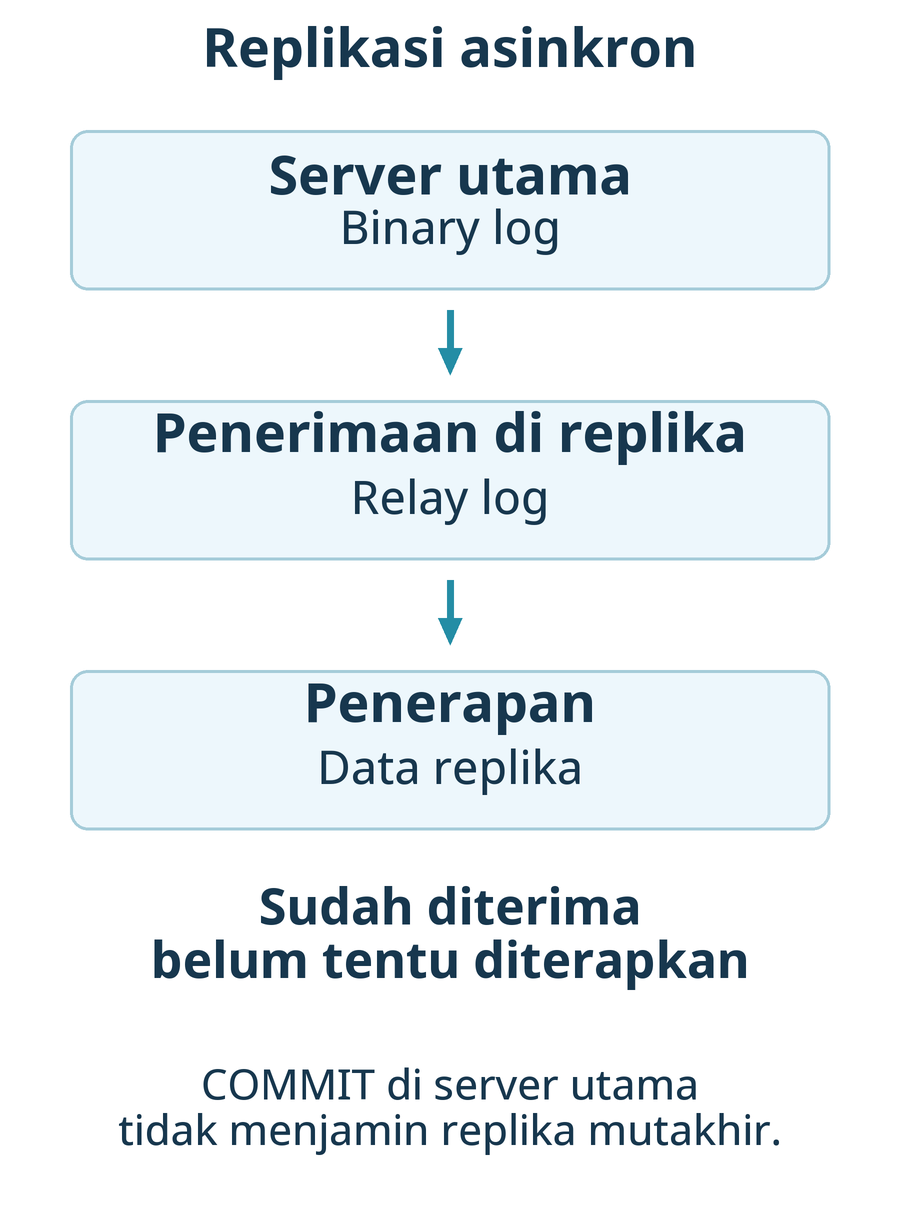
COMMIT yang berhasil pada server utama tidak berarti replika asinkron sudah menerapkan transaksi itu. Membaca replika segera sesudah menulis dapat menghasilkan nilai sebelumnya. Permintaan yang harus membaca perubahan terbaru memerlukan kebijakan perutean yang jelas. Panduan resmi penyiapan replikasi dan referensi GTID MariaDB menjelaskan pencatatan serta pengelolaan posisi.
GTID adalah Global Transaction ID, pengenal transaksi global untuk melacak posisi replikasi. Keberadaannya tidak otomatis memvalidasi data atau menjadikan setiap replika siap mengambil peran utama. MariaDB dan MySQL mempunyai implementasi GTID berbeda; nama yang sama tidak berarti sintaks serta perilakunya kompatibel.
Siapkan dua server baru untuk latihan pertama
Lewati penyiapan ini jika Anda sudah mempunyai replika belajar yang dikonfigurasi dengan benar. Jika belum, gunakan proyek baru dengan volume kosong, bukan server produksi atau replika yang sudah ada. Penyiapan mengikuti pendekatan berkas kata sandi pada lingkungan belajar MariaDB dengan Docker Compose.
Dalam folder baru, buat secrets/primary-root.txt dan secrets/replica-root.txt, masing-masing berisi kata sandi root yang berbeda dalam satu baris. Kecualikan secrets/ dari kendali versi dan lindungi akses berkas lokal. Simpan konfigurasi berikut sebagai compose.yaml. Tidak ada port host yang dipublikasikan; kedua server berkomunikasi pada jaringan Compose internal. mariadb:11.8 menunjuk keluarga versi pemeliharaan; catat digest yang disetujui jika reproduksi persis dibutuhkan.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
Pastikan Docker dan Compose tersedia, lalu jalankan perintah pada folder proyek baru. Jika nama proyek sudah dipakai, pilih nama lain sebelum memulai agar volume proyek sebelumnya tidak digunakan kembali.
docker compose config --quiet
docker compose up -d
docker compose ps
Tunggu hingga kedua layanan mencapai healthy. Atur replikasi sebelum memasukkan data aplikasi. Buka dahulu klien administrator lokal pada server utama:
docker compose exec primary mariadb -u root -pMasukkan kata sandi dari primary-root.txt. Ganti kata sandi demonstrasi publik pada blok berikut sebelum menjalankannya:
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
Baris terakhir \q keluar dari klien; itu perintah klien, bukan SQL server. Pola host % sendiri tidak memberikan hak administrator. Contoh ini hanya memberi hak replikasi di jaringan latihan terpisah tanpa port host yang dipublikasikan. Pemasangan jarak jauh memerlukan pembatasan asal koneksi yang sesuai dan Transport Layer Security (TLS), yaitu enkripsi koneksi. Jangan menerapkan cakupan latihan ini begitu saja pada jaringan bersama.
Selanjutnya, buka klien administrator pada replika dan masukkan kata sandi dari replica-root.txt:
docker compose exec replica mariadb -u root -pPada replika, gunakan kata sandi replikasi baru yang sama seperti pada server utama. Jangan memublikasikan perintah atau keluaran yang memuat rahasia asli.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
Penyiapan ini mengasumsikan dua server baru yang kosong dan log server utama yang masih tersedia. Data yang sudah ada atau log yang hilang memerlukan salinan awal konsisten dengan posisi yang sesuai terlebih dahulu. Pengaturan koneksi saja tidak menyelaraskan data yang berbeda. Periksa bahwa kedua thread menunjukkan Yes sebelum melanjutkan.
Verifikasi konfigurasi Docker pada lingkungan Anda melalui status layanan dan log kontainer. Percobaan pemindahan serta jeda di bawah diperiksa menggunakan dua server MariaDB 12.3.3 native sementara dengan ID berbeda, binary log ROW, dan GTID. Pengujian tersebut tidak merupakan pengujian eksekusi image Docker atau koneksi TLS jarak jauh.
Pastikan topologi dan hak diagnosis
Kueri berikut mendiagnosis topologi yang sudah dikonfigurasi. Topologi memerlukan server_id yang berbeda, binary log pada server utama, akun replikasi, jalur jaringan, dan data awal yang konsisten. Pemeriksaan status membutuhkan hak sesuai versi, misalnya REPLICA MONITOR, yang berbeda dari hak untuk mengendalikan thread. Aplikasi tidak otomatis membutuhkan seluruh hak administrator hanya untuk mendukung pemantauan operasional.
Pada server utama, periksa identitas serta binary log dan catat posisi saat ini:
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
Pada replika, jalankan:
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
Sejak MariaDB 12.0, read_only adalah enumerasi yang juga mengenal NO_LOCK dan NO_LOCK_NO_ADMIN. Tafsirkan nilainya menurut versi, bukan selalu mengharapkan angka 0 atau 1. Referensi read_only menjelaskan pilihan modenya.
\G mengakhiri pernyataan dan menampilkan hasil vertikal pada klien baris perintah mariadb. Jangan mengirimkannya tanpa perubahan melalui antarmuka SQL; pengandar mengirim pernyataan SQL lalu membaca kolom hasilnya.
Tafsirkan kolom status yang terkait secara bersama
| Kolom | Makna |
|---|---|
| Slave_IO_Running | Status penerimaan; Yes saja belum membuktikan data sudah diterapkan |
| Slave_SQL_Running | Status penerapan; bedakan jeda sengaja dari kesalahan |
| Last_IO_Error dan Last_SQL_Error | Bukti untuk membedakan kegagalan pengiriman atau autentikasi dari kegagalan penerapan |
| Seconds_Behind_Master | Indikator keterlambatan yang bergantung pada status dan waktu; 0 maupun NULL saja tidak membuktikan kesehatan |
| Gtid_IO_Pos dan @@GLOBAL.gtid_slave_pos | Posisi diterima dan diterapkan dalam konteks domain serta topologi yang dikonfigurasi |
Walaupun perintahnya SHOW REPLICA STATUS, kolom keluaran dapat tetap memakai nama historis Slave dan Master. Urutannya juga dapat berbeda menurut versi. Kode pemantauan sebaiknya membaca nama kolom, bukan posisi numerik tetap. Lihat referensi SHOW REPLICA STATUS.
Kedua thread yang berjalan, kedatangan satu perubahan bisnis tertentu, dan kehilangan data yang masih dapat diterima saat gangguan adalah pemeriksaan yang berbeda. Catat status dan posisi, lalu cocokkan data penting atau penanda pemrosesannya. Angka keterlambatan kecil tidak menyingkirkan perbedaan data akibat filter atau penulisan lokal replika yang tidak disengaja.
Amati jeda penerap pada lingkungan terpisah
Lakukan percobaan berikut hanya pada lingkungan replikasi terpisah yang boleh dibuang dengan hak pengendalian thread. Ini bukan prosedur menghentikan replika produksi saat diagnosis. Buat tabel uji pada server utama; jika nama objek sudah ada, periksa dahulu sebelum CREATE.
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
Pada replika, ulangi kueri berikut hingga baris pertama muncul. Jika tidak muncul, periksa status dan kesalahannya:
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;before-pause berarti sebelum jeda. Pada replika, hentikan hanya thread penerap. Penerima masih dapat mengumpulkan catatan sehingga perbedaan antara log yang diterima dan data yang terlihat dapat diamati.
STOP REPLICA SQL_THREAD;Pada server utama, tambahkan baris kedua. during-pause berarti selama jeda:
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');Kueri replika seharusnya masih menampilkan hanya baris pertama. Periksa SHOW REPLICA STATUS untuk memastikan penerima tetap berjalan sementara penerap berhenti. Segera setelah mengamati perbedaan, lanjutkan penerapan pada replika:
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
Jika tidak ada filter atau kesalahan yang menghalangi, baris kedua akan tiba. Penerapan membutuhkan waktu; satu SELECT langsung yang belum menampilkan baris itu tidak membuktikan kegagalan akhir. Sebaliknya, jangan menunggu tanpa batas tanpa memeriksa status dan kesalahan terakhir. Jangan menjalankan perintah pelanjutan pada lingkungan yang replikasinya sengaja dihentikan untuk pekerjaan lain.
Pastikan kedua thread kembali ke status berjalan semula. Setelah selesai, hapus tabel uji yang boleh dibuang pada server utama dengan DROP TABLE replication_lab.probe; dan periksa bahwa tabel juga hilang pada replika. Jangan menghapus objek bisnis atau mengatur ulang konfigurasi replikasi hanya untuk membersihkan tabel latihan ini.
Simpan bukti sebelum melewati event atau mengatur ulang posisi
| Masalah | Periksa dahulu | Hindari tanggapan tergesa-gesa |
|---|---|---|
| Penerima tidak dapat terhubung | Alamat, port, DNS, firewall, TLS, akun, dan kesalahan IO terakhir | Mematikan autentikasi atau enkripsi |
| Penerap berhenti | Kunci duplikat, baris hilang, perbedaan skema, filter, dan kesalahan SQL terakhir | Melewati event tanpa memahami akibatnya pada data |
| Log yang dibutuhkan sudah tidak tersedia | Retensi log utama, posisi replika, dan konsistensi salinan awal | Memaksakan posisi tanpa data konsisten yang sesuai |
| Keterlambatan terus meningkat | Volume penulisan, masukan/keluaran dan CPU replika, transaksi besar, serta kunci | Memilih server utama berdasarkan satu angka keterlambatan |
Simpan status dan kesalahan beserta waktu pengamatan terlebih dahulu. Jika data sudah menyimpang, pertimbangkan membangun ulang replika dari cadangan yang konsisten. Melewati event dapat membuat thread kembali berjalan sambil meninggalkan data yang hilang atau tidak konsisten. Replikasi juga dapat meneruskan DELETE yang keliru, sehingga tidak menggantikan cadangan independen atau verifikasi pemulihan.
Perlakukan failover sebagai pengendalian jalur penulisan
- Pastikan gangguan dan isolasi server utama sebelumnya dari penulisan baru. Putusnya satu jalur jaringan saja tidak membuktikan server tersebut berhenti menerima perubahan.
- Periksa posisi yang diterima dan diterapkan, pekerjaan tertunda, kesalahan, serta potensi kehilangan pada replika kandidat.
- Nilai Recovery Point Objective (RPO), yaitu batas kehilangan data yang dapat diterima, dan Recovery Time Objective (RTO), yaitu batas waktu pemulihan yang ditargetkan.
- Ikuti prosedur promosi peran dan perutean yang disetujui untuk menetapkan satu tujuan penulisan. Sesudahnya, periksa pembacaan serta penulisan aplikasi.
- Sebelum mengembalikan server utama lama, periksa konsistensinya dan bangun ulang sebagai replika jika diperlukan.
Pada mode ON yang digunakan contoh, read_only membatasi penulisan pengguna biasa; itu bukan penghalang mutlak bagi seluruh perubahan berhak istimewa. Periksa pengecualian hak pada replika hanya-baca. Mematikan read_only bukan prosedur failover yang lengkap. Mencegah split brain, yaitu dua server yang sama-sama menerima penulisan, memerlukan isolasi server utama sebelumnya serta pengendalian perutean dan koneksi secara terpadu.