MariaDB 教程 / 理解复制、延迟、错误与故障切换
MariaDB 标准异步复制把主服务器的变更日志传送到副本,再由副本应用这些变更。有副本并不保证数据已经追平,也不自动完成故障切换;应一起管理延迟、错误、可能的数据丢失和应用写入路径。
沿主服务器、接收与应用三个阶段跟踪变更
主服务器把变更写入二进制日志,副本的接收线程把日志取回中继日志,应用线程再将变更写入副本数据。并行复制可能有多个工作线程,但“已经收到”和“已经应用”仍是不同阶段。
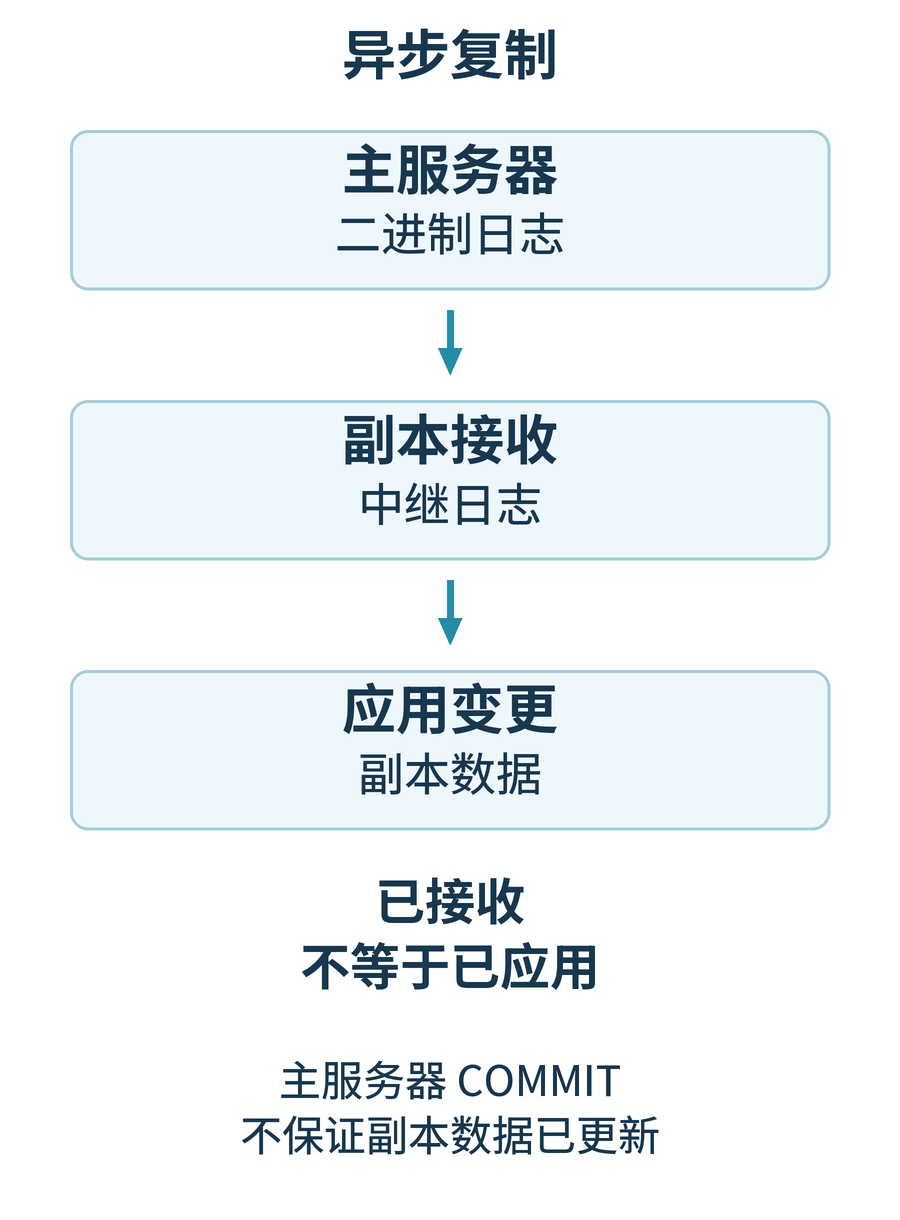
主服务器 COMMIT 成功,不表示异步副本已经完成对应事务。写入后立刻从副本查询可能看到旧值;要求写后读一致性的请求,需要明确的读取路由或等待策略。复制还可能传播误删,不能代替独立备份与恢复验证。
GTID 是全局事务标识(Global Transaction ID),用于识别变更组与复制位置。存在 GTID 不等于数据已验证一致,也不意味着任意副本都能提升为主。MariaDB 与 MySQL 的 GTID 实现不同,不能因名称相同就混用语法和行为,参见复制设置指南及MariaDB GTID 文档。
用两个全新空服务器准备首次练习
已有正确配置的独立学习副本时可跳过初始化。下面从Docker Compose 的密码文件与数据卷扩展为双服务器。使用新项目与空卷,不能套到生产服务器或已有副本上。
在新目录创建 secrets/primary-root.txt 和 secrets/replica-root.txt,每个文件一行、保存不同 root 密码,将 secrets/ 排除出版本控制并限制访问。把以下完整配置保存为 compose.yaml。它不发布宿主机端口,两台服务器通过内部 Compose 网络通信。
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
在该项目目录终端运行:
docker compose config --quiet
docker compose up -d
docker compose ps
确认两项服务均 healthy 后,在插入应用数据之前配置复制。镜像使用可移动的 11.8 系列标签,需要严格重现时记录批准的补丁或摘要。Compose 配置、镜像启动、网络与卷均需在实际 Docker 环境确认,不能用原生进程的 SQL 试验替代容器启动验证。
打开主服务器的本地管理客户端,在提示处输入其 root 文件密码:
docker compose exec primary mariadb -u root -p以下代码在主服务器客户端执行,先替换示例复制密码。\q 是客户端退出命令,不是服务器 SQL:
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
百分号来源匹配不代表管理员权限;这里只授予复制能力,且用于无发布端口的专用内部网络。真实远程部署需要限制来源并配置 TLS。授权输出可能含认证信息,不要公开真实密码、命令记录或原始输出。
再打开副本管理客户端:
docker compose exec replica mariadb -u root -p输入副本 root 密码后,在下列语句填入刚设置的复制密码:
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
初始化假设两台服务器全新、应用数据为空且主服务器日志仍可用。已有数据或缺失日志时,应先建立一致的初始副本和匹配位置;仅设置连接坐标不能修复已有数据差异。确认接收与应用线程都为 Yes,再做后续标记试验。
确认拓扑、服务器身份与诊断权限
复制需要不同 server_id、主服务器二进制日志、专用复制账户、可达路径及一致初始数据。状态查看与控制线程所需权限不同,按版本检查 REPLICA MONITOR 等诊断权限,不要让应用为监控而获得全部管理员能力。
在主服务器运行下面代码,核对身份、二进制日志并记录当前位置:
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;在副本运行下面代码。\G 是 mariadb 客户端的纵向输出结束符,SQL API 不应原样发送它:
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
本篇传输、暂停和恢复应用的验证环境是两台临时原生 MariaDB 12.3.3,使用不同编号、ROW 二进制日志与 GTID。该结果说明复制行为,不等于已验证 Compose 11.8 镜像启动、远程证书或生产故障切换。
结合多个状态字段判断接收与应用
| 字段 | 解释与限制 |
|---|---|
| Slave_IO_Running | 接收线程状态,Yes 不证明已应用到数据 |
| Slave_SQL_Running | 应用线程状态,区分人工暂停与错误停止 |
| Last_IO_Error、Last_SQL_Error | 区分传输或认证错误与应用错误 |
| Seconds_Behind_Master | 延迟指标需结合状态与时间解释,0 或 NULL 均不独立证明健康 |
| Gtid_IO_Pos、gtid_slave_pos | 接收位置与应用位置,结合配置域和拓扑判断 |
即使命令为 SHOW REPLICA STATUS,字段也可能保留旧的 Slave、Master 名称,顺序还会随版本改变。监控程序应按字段名取值,不依赖固定列序号;参见状态命令参考。
线程运行、指定业务写入已经到达、可接受的故障切换丢失窗口,是三个不同检查。应记录状态和位置并核对业务数据或标记。很小的延迟数字也不能排除过滤器、意外副本写入导致的数据分歧。
只在隔离环境暂停应用线程观察差异
此实验需要专用可丢弃复制环境与线程控制权限,不是生产排错时随意暂停副本的操作说明。先在主服务器创建探针,确认同名数据库与表未被其他用途使用:
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
在副本查询,等第一条标记确实到达后再继续:
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;仅在副本停止应用线程,接收线程仍可继续取得日志:
STOP REPLICA SQL_THREAD;然后在主服务器插入第二条标记:
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');此时副本应仍只有 before-pause 一行。结合状态确认接收线程仍为 Yes、应用线程为 No,接收位置可继续前进,而应用位置保持暂停前状态。这直接展示日志已经收到与查询已能看见数据的差别。
观察后立即在副本恢复应用,再查询:
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
没有冲突过滤或错误时,第二条 during-pause 应到达。复制应用需要时间,一次立即查询未看到不能独立判失败;也不要不查看状态与最后错误就无限等待。核对两条标记与主服务器一致、应用位置追平且线程恢复运行。
不要把恢复命令复制到因其他维护而有意暂停的环境。结束时只在主服务器删除确认可丢弃的探针表,并检查删除已传播到副本,不在两端各自执行不受控修改。
跳过事件或重置位置前,先保留证据
| 问题 | 优先检查 | 避免过早处理 |
|---|---|---|
| 接收线程连不上 | 地址、端口、DNS、防火墙、TLS、账户及 IO 错误 | 关闭认证或加密 |
| 应用停止 | 主键重复、缺行、结构差异、过滤器与 SQL 错误 | 不明数据影响就跳过事件 |
| 所需日志已不可用 | 日志保留、副本位置与初始拷贝一致性 | 没有匹配数据就强制指定位置 |
| 延迟持续增长 | 写入量、副本 IO、CPU、大事务与锁 | 只依据一个延迟值提升副本 |
先保存带时间的状态和错误。已有分歧时,应评估从一致备份重新建立副本。跳过事件可能让线程重新运行,却留下缺失或不一致的数据;误删也可能正常传播,所以复制不是独立恢复手段。
将故障切换视为写入路径的控制
- 确认故障并隔离旧主服务器的新写入;网络分区不证明旧主已停止接受写请求。
- 检查候选副本的接收、应用位置、积压任务、错误与潜在丢失。
- 评估恢复点目标 RPO(recovery point objective,可接受的数据丢失)和恢复时间目标 RTO(recovery time objective,可接受的恢复耗时)。
- 按批准的提升与路由流程建立唯一写入目标,并验证应用读写。
- 旧主恢复后先检查一致性,必要时重新建立为副本,再接回拓扑。
read_only 限制普通用户写入,却不是阻止所有特权写入的绝对屏障,参见只读副本的权限例外。关闭 read_only 不等于完整提升流程;防止两台服务器同时接受写入的脑裂,需要同时隔离旧主和控制连接路由。