MariaDB講座 / レプリケーションの遅延・障害・フェイルオーバーを理解する
通常の非同期レプリケーションは、プライマリーの変更記録をレプリカへ転送して適用します。複製があるだけで最新状態や自動切替が保証されるわけではなく、遅延、エラー、損失可能性とアプリケーションの書込先を合わせて管理します。
変更の受信と適用を分ける
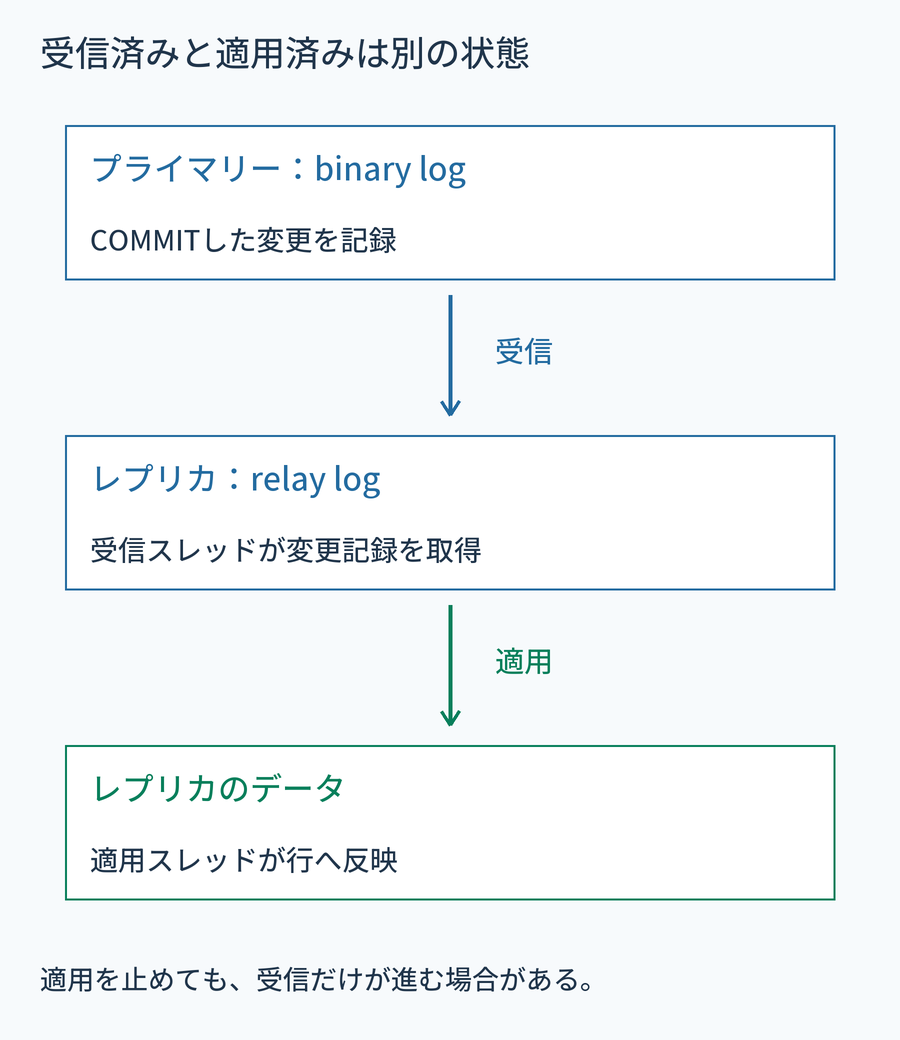
プライマリーはbinary logへ変更を記録し、受信側がrelay logへ取得し、適用側がDBへ反映します。並列ワーカーがあっても受信と適用は別段階です。プライマリーでCOMMITが成功しても非同期レプリカへ反映済みとは限らず、直後読取の経路を要件に合わせます。
GTIDはGlobal Transaction IDで複製位置を識別します。存在するだけでデータ一致や昇格準備を証明しません。MariaDBとMySQLの同名GTIDが同じ構文・動作とは考えません。誤った削除も複製されるため、独立したバックアップと復元確認を残します。
新しい二台を内部ネットワークで準備する
正しく構成済みの実習レプリカがある場合、この初期構築は省略できます。新規のプロジェクトと空ボリュームだけを使い、本番や既存複製へ適用しません。secrets/primary-root.txtとreplica-root.txtへ別々のパスワードを一行で保存し、secrets/をバージョン管理から除外します。Composeのファイルとボリュームを前提とします。
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
ホストのポートは公開せず、internalネットワークで二台を結びます。新規初期化後のパスワードファイル変更で既存アカウントは変更されません。系列タグを厳密に固定するなら承認済みdigest等を記録します。起動します。
docker compose config --quiet
docker compose up -d
docker compose ps
両方healthyを確認し、業務データを入れる前に次を設定します。
専用の複製アカウントで初期接続する
primary内の管理クライアントです。
docker compose exec primary mariadb -u root -p
固有の仮パスワードへ置き換え、実行します。
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
EXIT;
%はこの公開ポートなしの専用ネットワークで使う例で、与えるのは複製権限だけです。実リモートは適切な接続元制限とTLSが必要です。replicaへ接続します。
docker compose exec replica mariadb -u root -p
実際の複製パスワードを設定します。本物を出力や公開記録へ残しません。
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
これは新しい空の二台と必要なログが残る条件です。既存データやログ欠損なら、一貫した初期コピーと対応位置が必要で、接続先の指定だけでは一致しません。Composeは静的確認の範囲で、Docker上の起動・通信・ボリュームの検証とは区別します。
接続先と状態確認の権限を区別する
異なるserver_id、binary log、複製用アカウント、ネットワークと一致した初期データが必要です。監視用REPLICA MONITORなどの権限は、スレッドを操作する権限とは別です。アプリへ全管理権限を与える理由にはなりません。primaryで確認します。
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
replicaで確認します。
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
\Gはmariadbクライアントの縦表示終端で、SQL APIへそのまま送りません。この教材の受信・適用停止と再開の検証記録は、異なるID、ROWログとGTIDを持つ一時的なMariaDB 12.3.3二台です。実リモートTLSや本番切替を実行したものではありません。
複数の状態と業務データを照合する
| 項目 | 読み方 |
|---|---|
| Slave_IO_Running | 受信側。Yesだけでは適用完了ではない |
| Slave_SQL_Running | 適用側。意図した停止とエラーを分ける |
| Last_IO_Error / Last_SQL_Error | 経路・認証と適用エラーを分ける証拠 |
| Seconds_Behind_Master | 状態や時点に依存する遅延指標。0やNULLだけで健康判定しない |
| Gtid_IO_Pos / gtid_slave_pos | 受信と適用位置。ドメインと構成も含めて読む |
SHOW REPLICA STATUSでも出力名に旧Slave/Masterが残る場合があります。列順ではなく名前で読みます。両スレッド稼働、特定の業務変更の到着、許容損失は別の確認です。フィルターや意図しないレプリカ書込による不一致は、小さい遅延だけで否定できません。
適用側だけを止めて差を観察する
専用の破棄可能な実習複製でだけ行います。primaryで最初のマーカーを作ります。
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
replicaで最初の到着を確認します。
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
replicaの適用側だけを止めます。
STOP REPLICA SQL_THREAD;
primaryで二番目を追加します。
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');
replicaにはまだ二番目がなく、受信は進められる状態をステータスでも読みます。観察したらreplicaですぐ再開します。
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
適用は少し時間がかかるため即一回のSELECTだけで失敗とせず、無期限にも待たず状態と最終エラーを見ます。元の稼働へ戻ったか確認し、不要なprobeはprimaryで削除してreplicaへ反映することも確認します。他作業で意図停止した環境へ再開命令をコピーしません。
スキップや位置変更の前に証拠を保存する
受信不能なら住所・ポート・DNS・FW・TLS・アカウント・IOエラー、適用停止なら重複キー・欠落行・構造差・フィルター・SQLエラーを調べます。ログがない場合は保持、位置と初期コピー、増え続ける遅延は書込量、IO、CPU、大トランザクションとロックを見ます。
時刻付きの状態とエラーを保存し、データが分岐したなら整合したバックアップからの再構成も検討します。イベントを飛ばしてスレッドだけ再開しても、欠損や不整合が残る場合があります。
フェイルオーバーは書込経路の管理である
障害を確認し、旧primaryへの新規書込を遮断します。ネットワーク分断だけでは、そのサーバーが書込を受けない証明にはなりません。候補の受信・適用位置、保留処理、エラーと損失可能性を読み、RPO(許容するデータ損失の目標)とRTO(復旧までの時間目標)を評価します。
承認された昇格と接続切替の手順で書込先を一つにし、アプリの読書きを確認します。旧primaryを戻す前には一致を検証し、必要ならレプリカとして再構築します。read_onlyにも特権書込の例外があり、OFFにするだけで昇格完了とはなりません。二台が書き込むsplit brainを防ぐため、旧primaryの隔離とルーティングを一緒に管理します。