Corso MariaDB / Replica, ritardo, errori e failover
La replica asincrona standard di MariaDB trasferisce le registrazioni delle modifiche dal server primario a una replica, che le applica ai propri dati. La presenza di una replica non garantisce dati già aggiornati né un passaggio automatico a un altro server. Ritardo, errori, possibile perdita di dati e destinazione delle scritture dell’applicazione vanno gestiti insieme.
Seguire una modifica dal primario alla replica
Il primario registra le modifiche nel binary log, il registro binario. Il thread ricevitore della replica le trasferisce nel relay log, un registro intermedio locale. Il thread di applicazione le esegue sui dati della replica. La replica parallela può impiegare più lavoratori, ma ricevere e applicare restano due fasi distinte.
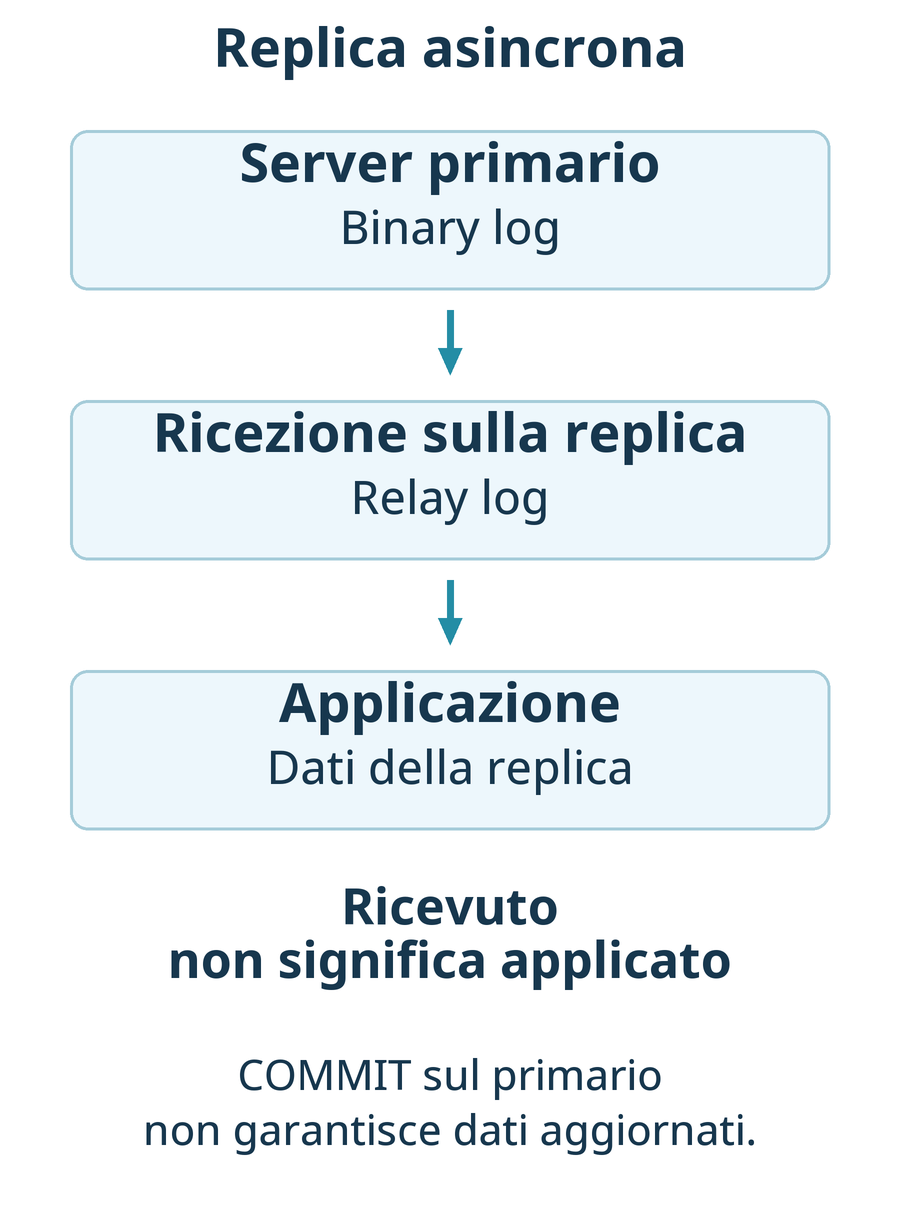
Il successo di COMMIT sul primario non implica che una replica asincrona abbia già applicato la transazione. Una lettura sulla replica subito dopo una scrittura può restituire il valore precedente. Le richieste che devono vedere la modifica appena confermata richiedono quindi una precisa politica di instradamento delle letture. La guida ufficiale alla configurazione della replica descrive i requisiti di log, identificazione e connessione.
GTID significa Global Transaction ID, identificatore globale della transazione: consente di seguire la posizione di replica degli eventi. Non convalida automaticamente i dati e non rende qualsiasi replica pronta alla promozione. MariaDB e MySQL hanno implementazioni GTID differenti; il nome comune non ne garantisce la compatibilità. La documentazione GTID di MariaDB chiarisce formato e gestione delle posizioni.
Preparare due server nuovi per la prima esercitazione
Se si dispone già di una replica didattica configurata correttamente, si può passare alla diagnosi. Altrimenti usare un progetto nuovo con volumi vuoti, separato dai server operativi e dalle repliche esistenti. La preparazione riprende il metodo con file delle password dell’ambiente MariaDB con Docker Compose.
In una cartella nuova creare secrets/primary-root.txt e secrets/replica-root.txt, ciascuno con una diversa password root su una sola riga. Escludere secrets/ dal controllo di versione e limitare l’accesso ai file locali. Salvare la configurazione seguente in compose.yaml. Non vengono pubblicate porte sull’host: i server comunicano tramite la rete interna Compose. Il tag mariadb:11.8 identifica una famiglia di manutenzione; per riprodurre esattamente un’immagine occorre annotare il digest approvato.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
Verificare che Docker e Compose siano disponibili, quindi eseguire i comandi nella nuova cartella. Se il nome del progetto è già in uso, sceglierne un altro prima dell’avvio per evitare di riutilizzare i volumi del progetto precedente.
docker compose config --quiet
docker compose up -d
docker compose ps
Attendere che entrambi i servizi risultino healthy. Configurare la replica prima di inserire dati applicativi. Aprire prima il client amministrativo locale del primario:
docker compose exec primary mariadb -u root -pInserire la password di primary-root.txt. Prima di eseguire il blocco seguente, sostituire la password dimostrativa pubblica con una password nuova:
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
L’ultima riga, \q, chiude il client: è un comando del client, non SQL del server. Il solo modello di host % non conferisce privilegi amministrativi. Qui l’account riceve esclusivamente il privilegio di replica, in una rete didattica isolata senza porte host pubblicate. Per connessioni remote occorrono restrizioni appropriate sull’origine e Transport Layer Security (TLS), la cifratura della connessione. Non trasferire automaticamente questa configurazione di esercitazione a una rete condivisa.
Aprire quindi il client amministrativo sulla replica e inserire la password di replica-root.txt:
docker compose exec replica mariadb -u root -pSulla replica usare la stessa nuova password dell’account di replica creato sul primario. Non pubblicare comandi o risultati contenenti segreti reali.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
Questa configurazione presuppone due server nuovi e vuoti e la disponibilità dei log necessari sul primario. Se esistono già dati o mancano i log, serve prima una copia iniziale coerente con la posizione corrispondente. Impostare la connessione non riallinea dati già diversi. Controllare che entrambi i thread mostrino Yes prima di proseguire.
Nel proprio ambiente verificare anche lo stato dei servizi e i log dei container. L’esercitazione di trasferimento e pausa descritta sotto è stata verificata con due server temporanei nativi MariaDB 12.3.3, identificatori distinti, binary log ROW e GTID. Questa verifica non costituisce una prova di avvio dell’immagine Docker né di connessione TLS remota.
Controllare topologia e privilegi di diagnosi
Le query seguenti diagnosticano una topologia già configurata. Occorrono server_id diversi, binary log sul primario, un account di replica, connettività e dati iniziali coerenti. La lettura dello stato richiede i privilegi previsti dalla versione, per esempio REPLICA MONITOR, distinti dai privilegi di controllo dei thread. Il monitoraggio operativo non richiede di assegnare automaticamente all’applicazione tutti i privilegi amministrativi.
Sul primario controllare identità e binary log e annotare la posizione corrente:
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
Sulla replica eseguire:
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
Da MariaDB 12.0 read_only è un’enumerazione che include anche NO_LOCK e NO_LOCK_NO_ADMIN. Interpretarne il valore in base alla versione, senza aspettarsi sempre i numeri 0 e 1. Il riferimento di read_only descrive le modalità disponibili.
\G termina l’istruzione e presenta il risultato in verticale nel client da riga di comando mariadb. Non inviarlo senza modifiche tramite un’interfaccia SQL: un driver invia l’istruzione SQL e legge i campi del risultato.
Interpretare insieme i campi dello stato
| Campo | Significato |
|---|---|
| Slave_IO_Running | Stato della ricezione; Yes da solo non prova che i dati siano già applicati |
| Slave_SQL_Running | Stato dell’applicazione; distinguere una pausa voluta da un arresto per errore |
| Last_IO_Error e Last_SQL_Error | Indizi per distinguere problemi di trasporto o autenticazione dagli errori di applicazione |
| Seconds_Behind_Master | Indicatore di ritardo dipendente da stato e tempi; né 0 né NULL dimostrano da soli il corretto funzionamento |
| Gtid_IO_Pos e @@GLOBAL.gtid_slave_pos | Posizioni ricevuta e applicata nel contesto dei domini e della topologia configurati |
Anche quando il comando si chiama SHOW REPLICA STATUS, le colonne possono conservare i nomi storici Slave e Master. Il loro ordine può variare con la versione. Il software di monitoraggio dovrebbe leggere i nomi dei campi, evitando posizioni numeriche fisse. Consultare il riferimento di SHOW REPLICA STATUS.
Accertare che i thread siano attivi, verificare l’arrivo di una particolare modifica applicativa e valutare la perdita di dati accettabile durante un guasto sono controlli diversi. Registrare stato e posizioni e confrontare i dati importanti o appositi marcatori di elaborazione. Un ritardo basso non esclude differenze dovute a filtri o scritture locali accidentali sulla replica.
Osservare una pausa dell’applicazione in un ambiente separato
Eseguire questa prova solo su una topologia di esercitazione separata ed eliminabile, con i privilegi di controllo dei thread. Non è una procedura per fermare una replica operativa durante la diagnosi. Creare sul primario la tabella di prova; se il nome esiste già, esaminarlo prima di CREATE.
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
Sulla replica ripetere la query seguente finché appare la prima riga. Se non arriva, controllare stato ed errori:
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;before-pause significa «prima della pausa». Sulla replica fermare soltanto il thread di applicazione. Il ricevitore può continuare ad accumulare eventi: diventa così osservabile la differenza tra log ricevuti e dati disponibili alle query.
STOP REPLICA SQL_THREAD;Sul primario aggiungere la seconda riga. during-pause significa «durante la pausa»:
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');La query sulla replica dovrebbe mostrare ancora soltanto la prima riga. Con SHOW REPLICA STATUS verificare che il ricevitore sia attivo mentre l’applicazione è ferma. Appena osservata la differenza, riprendere l’applicazione sulla replica:
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
In assenza di filtri o errori che la impediscano, arriverà anche la seconda riga. L’applicazione richiede tempo: una SELECT immediata senza la nuova riga non prova un guasto definitivo. Evitare però un’attesa indefinita senza esaminare stato e ultimi errori. Non eseguire il comando di ripresa su un ambiente dove la replica è stata fermata intenzionalmente per altre attività.
Verificare che entrambi i thread siano tornati nello stato attivo iniziale. Al termine eliminare soltanto la tabella di esercitazione sul primario con DROP TABLE replication_lab.probe; e verificare che scompaia anche sulla replica. Per pulire questa prova non cancellare oggetti applicativi e non azzerare la configurazione di replica.
Conservare le evidenze prima di saltare eventi o cambiare posizione
| Problema | Primi controlli | Reazione affrettata da evitare |
|---|---|---|
| Il ricevitore non si connette | Indirizzo, porta, DNS, firewall, TLS, account e ultimo errore IO | Disattivare autenticazione o cifratura |
| L’applicazione degli eventi si arresta | Chiavi duplicate, righe mancanti, schemi diversi, filtri e ultimo errore SQL | Saltare l’evento senza valutarne le conseguenze sui dati |
| I log necessari non sono più disponibili | Conservazione dei log sul primario, posizione della replica e coerenza della copia iniziale | Forzare una posizione priva dei dati coerenti corrispondenti |
| Il ritardo continua ad aumentare | Volume delle scritture, CPU e ingresso/uscita della replica, transazioni grandi e blocchi | Scegliere il nuovo primario in base a un solo indicatore di ritardo |
Salvare prima stato ed errori con l’ora dell’osservazione. Se i dati sono già divergenti, valutare la ricostruzione della replica da una copia coerente. Saltare un evento può riattivare i thread lasciando dati mancanti o incoerenti. La replica può propagare anche una DELETE errata: non sostituisce un backup indipendente né la verifica del ripristino.
Gestire il failover come controllo delle scritture
- Accertare il guasto e isolare il vecchio primario da nuove scritture. L’interruzione di un solo percorso di rete non dimostra che il server abbia smesso di ricevere modifiche.
- Esaminare sulla replica candidata posizioni ricevute e applicate, lavoro ancora da applicare, errori e possibile perdita di dati.
- Valutare il Recovery Point Objective (RPO), il limite accettabile di perdita dei dati, e il Recovery Time Objective (RTO), il tempo obiettivo per il ripristino del servizio.
- Seguire la procedura approvata di promozione e instradamento per stabilire un’unica destinazione delle scritture. Verificare poi letture e scritture dell’applicazione.
- Prima di reinserire il vecchio primario, controllarne la coerenza e ricostruirlo come replica se necessario.
Nella modalità ON usata dall’esempio, read_only limita le scritture degli utenti ordinari; non impedisce in modo assoluto tutte le modifiche privilegiate. Controllare le eccezioni dei privilegi sulle repliche di sola lettura. Disattivare read_only non costituisce una procedura completa di failover. Evitare lo split brain, cioè due server che accettano contemporaneamente scritture, richiede l’isolamento del vecchio primario e il controllo coordinato di instradamento e connessioni.