Cours MariaDB / Comprendre la réplication, le retard, les erreurs et le basculement
La réplication asynchrone standard de MariaDB transmet les changements d’un serveur principal à une réplique, qui les applique à ses données. Posséder une réplique ne garantit ni qu’elle est à jour ni qu’un basculement sera automatique : il faut gérer ensemble le retard, les erreurs, la perte possible de données et le chemin d’écriture de l’application.
Suivre un changement du principal à la réplique
Le principal écrit ses changements dans le journal binaire. Le thread de réception de la réplique récupère ces enregistrements dans un journal relais ; le mécanisme d’application les exécute ensuite sur ses données. La réplication parallèle peut mobiliser plusieurs travailleurs, mais recevoir un changement et l’appliquer restent deux étapes distinctes.
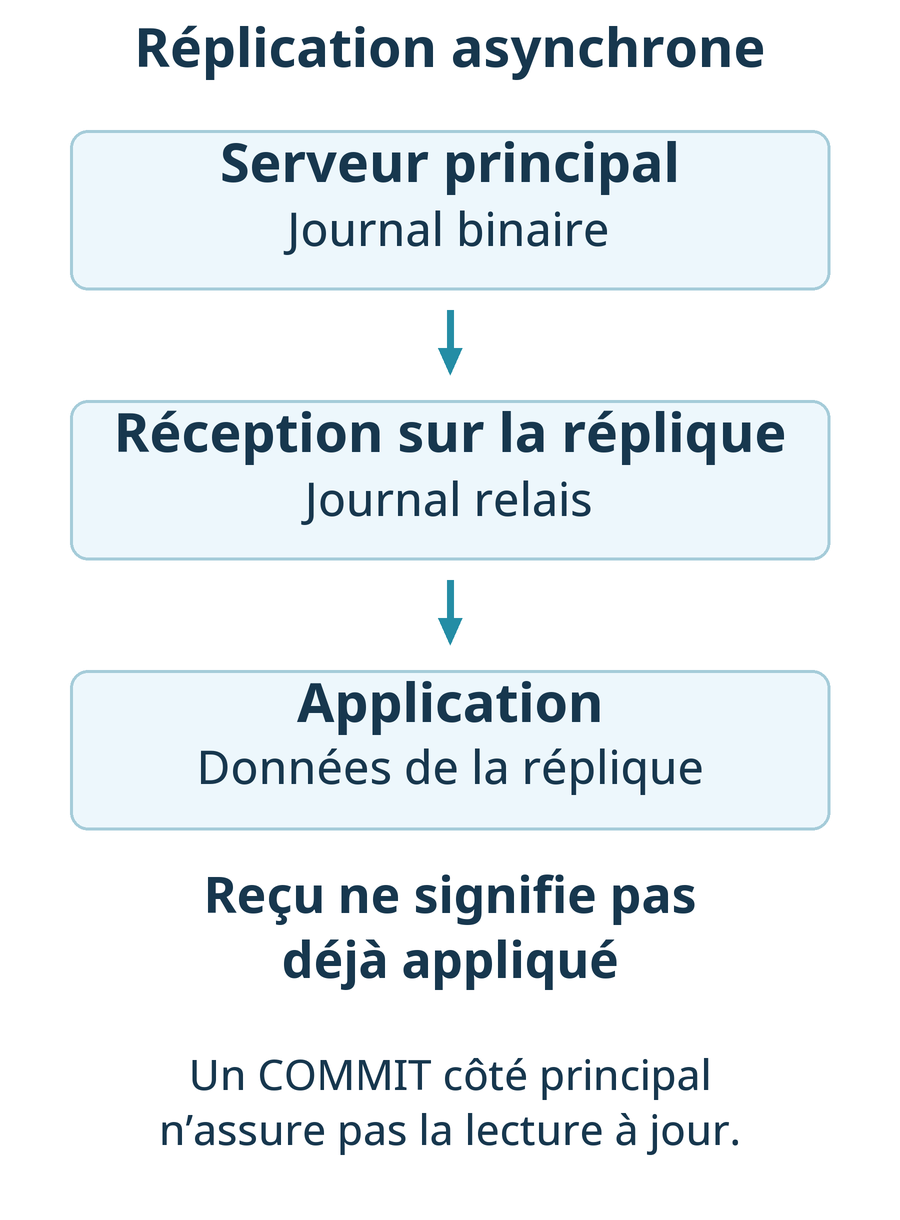
Un COMMIT réussi sur le principal ne signifie pas qu’une réplique asynchrone a fini d’appliquer cette transaction. Une lecture sur la réplique immédiatement après une écriture peut donc renvoyer une valeur antérieure. Les demandes exigeant une lecture à jour après écriture nécessitent une politique explicite de routage. Les documentations de mise en place de la réplication et des GTID MariaDB décrivent les journaux et les positions.
GTID signifie Global Transaction ID, identifiant global de transaction, utilisé pour suivre les positions de réplication. Sa présence ne valide pas automatiquement les données et ne rend pas toute réplique apte à devenir principale. MariaDB et MySQL ont des implémentations GTID différentes : le nom commun ne garantit pas la compatibilité de leurs syntaxes et comportements.
Préparer deux nouveaux serveurs pour un premier essai
Ignorez cette préparation si vous disposez déjà d’une réplique d’apprentissage correctement configurée. Pour un premier essai, utilisez un nouveau projet et des volumes vides, jamais des serveurs de production ou une réplique préexistante. Cette configuration reprend le principe des fichiers secrets du laboratoire MariaDB avec Docker Compose.
Dans un nouveau dossier, créez secrets/primary-root.txt et secrets/replica-root.txt, chacun avec un mot de passe root différent sur une seule ligne. Excluez secrets/ du contrôle de version et protégez les fichiers locaux. Enregistrez ce fichier compose.yaml. Aucun port hôte n’est publié ; les deux serveurs communiquent sur un réseau Compose interne. Le tag mariadb:11.8 suit une famille de versions correctives : consignez un digest approuvé si la reproductibilité exacte l’exige.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
Vérifiez la disponibilité de Docker et de Compose, puis lancez les commandes depuis ce dossier. Si le nom de projet est déjà utilisé, choisissez un autre nom avant de démarrer afin de ne pas réutiliser ses volumes.
docker compose config --quiet
docker compose up -d
docker compose ps
Attendez l’état healthy des deux services. Configurez la réplication avant d’insérer des données applicatives. Ouvrez d’abord un client administrateur local dans le principal :
docker compose exec primary mariadb -u root -pSaisissez le mot de passe de primary-root.txt, puis remplacez le mot de passe public de démonstration avant d’exécuter :
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
\q
La dernière ligne \q quitte le client ; c’est une commande du client, pas une instruction SQL du serveur. Le motif d’hôte % n’accorde pas à lui seul des droits d’administrateur : le compte reçoit ici uniquement le droit de réplication, dans un réseau d’exercice sans ports publiés. Un déploiement distant réel exige une restriction d’origine adaptée et une politique TLS. Ne transposez pas ce périmètre de laboratoire directement sur un réseau partagé.
Ouvrez ensuite le client administrateur de la réplique et saisissez le mot de passe de replica-root.txt :
docker compose exec replica mariadb -u root -pDans cette connexion, fournissez le même nouveau mot de passe de réplication que sur le principal. Ne publiez ni commandes ni sorties contenant un vrai secret.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
Cette initialisation suppose deux serveurs neufs et vides, avec les journaux nécessaires encore disponibles sur le principal. Pour une réplique ayant déjà des données ou si des journaux manquent, préparez d’abord une copie initiale cohérente et sa position correspondante. Les seules coordonnées de connexion ne réconcilient pas des données divergentes. Vérifiez que les deux threads affichent Yes avant de poursuivre les expériences.
Le montage Docker reste à vérifier dans votre environnement avec les contrôles de santé et les journaux des conteneurs. Les expériences de transfert et de pause ci-dessous ont été vérifiées avec deux serveurs natifs temporaires MariaDB 12.3.3, utilisant des identifiants distincts, le journal binaire ROW et les GTID ; cela ne constitue pas un essai de démarrage de l’image Docker ni un déploiement TLS distant.
Établir la topologie et les droits de diagnostic
Les commandes suivantes examinent une topologie déjà configurée. Elle nécessite des server_id différents, le journal binaire du principal, un compte de réplication, un chemin réseau fonctionnel et des données initialement cohérentes. L’inspection d’état requiert les droits adaptés à la version, par exemple REPLICA MONITOR, distincts des droits permettant d’arrêter les threads. Une application n’a pas besoin d’un accès administrateur complet pour permettre une supervision d’exploitation.
Sur le principal, confirmez son identité et le journal binaire, puis relevez la position courante :
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
Sur la réplique, exécutez :
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
À partir de MariaDB 12.0, read_only est une énumération proposant aussi NO_LOCK et NO_LOCK_NO_ADMIN. Interprétez la valeur selon la version plutôt que de supposer un résultat numérique 0 ou 1 ; la référence de read_only décrit ces modes.
\G est un terminateur d’affichage vertical du client en ligne de commande mariadb. Ce n’est pas un fragment à envoyer tel quel par une API SQL : un pilote doit envoyer l’instruction SQL et lire ses colonnes de résultat.
Interpréter ensemble les champs d’état
| Champ | Interprétation |
|---|---|
| Slave_IO_Running | État de réception ; Yes ne prouve pas à lui seul l’application des données |
| Slave_SQL_Running | État d’application ; distinguez un arrêt volontaire d’une erreur |
| Last_IO_Error et Last_SQL_Error | Indices pour séparer le transport ou l’authentification d’un échec d’application |
| Seconds_Behind_Master | Indicateur de retard dépendant de l’état et du moment ; ni 0 ni NULL ne prouve seul la bonne santé |
| Gtid_IO_Pos et @@GLOBAL.gtid_slave_pos | Positions reçue et appliquée, à interpréter selon les domaines et la topologie |
Même avec la commande SHOW REPLICA STATUS, les colonnes peuvent conserver les noms historiques Slave et Master. Leur ordre peut aussi varier selon la version ; un programme de supervision doit les lire par leur nom plutôt que par une position numérique fixe. La référence SHOW REPLICA STATUS décrit les champs.
Deux threads actifs, l’arrivée d’une écriture métier précise et une perte potentielle acceptable lors d’un basculement sont des contrôles différents. Relevez les états et positions, puis rapprochez-les des données ou marqueurs métier nécessaires. Un faible retard affiché n’exclut pas une divergence liée à des filtres ou à des écritures involontaires sur la réplique.
Observer une pause de l’application dans le laboratoire
Effectuez ces opérations uniquement dans une topologie séparée et jetable, avec les droits de contrôle des threads. Ce n’est pas une procédure pour arrêter une réplique de production pendant un diagnostic. Sur le principal, créez la sonde suivante ; si son nom existe déjà, examinez-la avant de répéter la création :
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
Sur la réplique, répétez cette lecture jusqu’à voir la première ligne, ou examinez l’état et les erreurs si elle n’arrive pas :
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;Sur la réplique, arrêtez uniquement le thread d’application. La réception peut continuer à collecter les enregistrements : c’est ce qui permet d’observer la différence entre journal reçu et données visibles.
STOP REPLICA SQL_THREAD;Sur le principal, ajoutez la deuxième ligne :
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');La lecture sur la réplique doit encore montrer seulement la première ligne. Examinez aussi SHOW REPLICA STATUS pour constater la différence d’état entre réception et application. Dès que cette observation est faite, reprenez l’application sur la réplique :
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
En l’absence de filtres ou d’erreurs bloquantes, la deuxième ligne doit arriver. L’application prend du temps : une seule lecture immédiate sans cette ligne ne constitue pas un échec définitif. À l’inverse, n’attendez pas indéfiniment sans examiner les états et la dernière erreur. Ne copiez pas une commande de reprise dans une installation dont la réplication a été arrêtée volontairement pour une autre opération.
Confirmez le retour à l’état actif initial. Quand les données de sonde peuvent être abandonnées, supprimez sa table depuis le principal avec DROP TABLE replication_lab.probe;, puis confirmez la disparition sur la réplique. Ne supprimez pas un objet métier et ne réinitialisez pas la configuration de réplication pour nettoyer cette seule table.
Conserver les preuves avant de sauter ou réinitialiser un événement
| Problème | Examiner d’abord | Réponse prématurée à éviter |
|---|---|---|
| Réception impossible | Adresse, port, DNS, pare-feu, TLS, compte et dernière erreur IO | Désactiver l’authentification ou le chiffrement |
| Application arrêtée | Clés dupliquées, lignes manquantes, différences de schéma, filtres et dernière erreur SQL | Sauter un événement sans comprendre son effet sur les données |
| Journal requis indisponible | Conservation des journaux du principal, position de la réplique et cohérence de la copie initiale | Forcer une position sans jeu de données cohérent correspondant |
| Retard croissant | Volume d’écriture, entrées-sorties et CPU de la réplique, grosses transactions et verrous | Promouvoir un serveur sur la foi d’un seul indicateur de retard |
Conservez d’abord les états et erreurs horodatés. En cas de divergence, envisagez une reconstruction depuis une sauvegarde cohérente. Sauter un événement peut remettre les threads en marche tout en laissant des données manquantes ou incohérentes. La réplication peut également propager un DELETE erroné : elle ne remplace ni des sauvegardes indépendantes ni la vérification de leur restauration.
Traiter le basculement comme un contrôle du chemin d’écriture
- Établissez la défaillance et isolez l’ancien principal des nouvelles écritures. Une coupure réseau ne prouve pas à elle seule qu’il a cessé d’accepter des écritures.
- Examinez les positions reçues et appliquées des répliques candidates, le travail restant, les erreurs et les données potentiellement perdues.
- Évaluez le RPO, Recovery Point Objective, qui définit la perte de données acceptable, et le RTO, Recovery Time Objective, qui définit le délai de reprise acceptable.
- Suivez la procédure approuvée de promotion et de routage pour établir une seule destination d’écriture, puis vérifiez les lectures et écritures de l’application.
- Avant de réintroduire l’ancien principal rétabli, contrôlez sa cohérence et reconstruisez-le comme réplique si nécessaire.
Dans le mode ON utilisé par cet exemple, read_only limite les écritures des utilisateurs ordinaires ; il n’est pas une barrière absolue contre toutes les écritures privilégiées. Les exceptions de droits des répliques en lecture seule doivent être prises en compte. Désactiver read_only n’est pas une procédure complète de promotion. Éviter le split brain, situation où deux serveurs acceptent simultanément les écritures, exige d’isoler l’ancien principal et de contrôler le routage des connexions.