MariaDB 강좌 / WITH로 공통 테이블 식 만들고 쿼리 나누기
WITH로 정의하는 공통 테이블 식(CTE, Common Table Expression)은 한 SQL 문 안에서 사용할 중간 조회 결과에 이름을 붙이는 기능입니다. 복잡한 조건과 집계를 단계별로 나누어 읽기 쉽게 만들지만, 영구 테이블을 만들거나 실행 속도를 자동으로 보장하는 기능은 아닙니다.
중간 결과마다 한 가지 역할 부여하기
결제 주문 선택, 주문별 상품 금액 계산, 고객 이름 연결을 한 문장에 섞으면 조건과 행 단위를 추적하기 어렵습니다. paid_orders는 대상 주문, order_totals는 주문당 한 금액이라는 역할을 갖게 나누겠습니다. 이름만 예쁘게 붙이는 대신 각 결과의 열·키·행 단위를 설명할 수 있어야 합니다. 중간 결과를 나눈 뒤 순위·누적을 붙이는 응용은 윈도 함수로 순번과 순위 계산하기와 윈도 함수로 누적 합계와 이전·다음 행 비교하기, 자기 결과를 반복 참조하는 구조는 재귀 CTE로 계층 데이터 조회하고 순환 막기에서 실습합니다.
| 중간 결과 | 한 행의 의미 | 주요 열 |
|---|---|---|
| paid_orders | paid 주문 한 건 | order_id, customer_id |
| order_totals | 주문별 상세 합계 | order_id, goods_total |
| 최종 결과 | 대상 주문 한 건 | 고객 이름·주문 상품 금액 |
독립된 주문 데이터와 CTE 준비하기
학습용 MariaDB 서버의 shopcourse에 course_user로 접속합니다. 명령줄 클라이언트와 UTF-8 SQL 파일 실행 방법대로 코드를 UTF-8 파일에 저장하고 SOURCE C:/mariadb-lab/lesson.sql;처럼 실제 파일 경로로 실행할 수 있습니다. SQL 문은 운영체제 터미널이 아닌 MariaDB 연결 안에서 실행합니다.
먼저 SELECT VERSION(), DATABASE();와 SHOW TABLES;로 대상 서버·DB·이름 중복을 확인합니다. 아래 c31_customers, c31_products, c31_orders, c31_items는 이 글의 독립된 연습용 이름입니다. 이미 존재하면 정의와 행을 확인하고, 보관할 자료가 없는 이 글의 실습 테이블임이 확실할 때만 마지막 절의 정리 순서로 지운 뒤 다시 만듭니다. 기존 강좌의 동명 없는 테이블이나 운영 데이터는 삭제하지 않습니다.
USE shopcourse;
CREATE TABLE c31_customers (
 customer_id INT NOT NULL PRIMARY KEY,
 customer_name VARCHAR(50) NOT NULL,
 city VARCHAR(30) NOT NULL
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
CREATE TABLE c31_products (
 product_id INT NOT NULL PRIMARY KEY,
 product_name VARCHAR(100) NOT NULL,
 category VARCHAR(30) NOT NULL,
 price DECIMAL(10,2) NOT NULL CHECK (price >= 0),
 stock INT NOT NULL CHECK (stock >= 0)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
CREATE TABLE c31_orders (
 order_id INT NOT NULL PRIMARY KEY,
 customer_id INT NOT NULL,
 ordered_at DATETIME NOT NULL,
 status VARCHAR(20) NOT NULL,
 shipping_fee DECIMAL(10,2) NOT NULL DEFAULT 1000,
 CONSTRAINT fk_c31_order_customer FOREIGN KEY (customer_id)
  REFERENCES c31_customers(customer_id) ON DELETE RESTRICT
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
CREATE TABLE c31_items (
 order_id INT NOT NULL,
 product_id INT NOT NULL,
 quantity INT NOT NULL CHECK (quantity > 0),
 unit_price DECIMAL(10,2) NOT NULL CHECK (unit_price >= 0),
 PRIMARY KEY (order_id, product_id),
 CONSTRAINT fk_c31_item_order FOREIGN KEY (order_id)
  REFERENCES c31_orders(order_id) ON DELETE RESTRICT,
 CONSTRAINT fk_c31_item_product FOREIGN KEY (product_id)
  REFERENCES c31_products(product_id) ON DELETE RESTRICT
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
INSERT INTO c31_customers VALUES
 (1,'김민수','서울'),(2,'이서연','부산'),
 (3,'박지우','서울'),(4,'최하늘','대전');
INSERT INTO c31_products VALUES
 (1,'노트','문구',3500,20),(2,'볼펜','문구',1500,50),
 (3,'머그컵','생활',8000,12),(4,'스탠드','생활',25000,5);
INSERT INTO c31_orders
 (order_id,customer_id,ordered_at,status,shipping_fee) VALUES
 (101,1,'2026-01-10 10:00:00','paid',1000),
 (102,1,'2026-01-20 11:00:00','paid',1000),
 (103,2,'2026-02-05 12:00:00','paid',1000),
 (104,3,'2026-02-10 13:00:00','canceled',1000);
INSERT INTO c31_items VALUES
 (101,1,2,3500),(101,2,3,1500),(102,3,1,8000),
 (103,1,1,3500),(103,3,2,8000),(104,2,1,1500);
paid 주문 세 건과 취소 주문 한 건을 사용합니다. 상세 합계를 주문별로 먼저 만들기 때문에 주문 헤더 값이 상세 수만큼 중복되는 문제도 추적하기 쉽습니다. 서버 버전과 WITH 지원 여부는 SELECT VERSION();로 확인하고 해당 버전의 WITH 문법을 참고하세요.
쉼표로 여러 CTE를 정의하고 최종 조회하기
WITH paid_orders AS (
 SELECT order_id,customer_id FROM c31_orders WHERE status='paid'
), order_totals AS (
 SELECT order_id,SUM(quantity*unit_price) AS goods_total
 FROM c31_items GROUP BY order_id
)
SELECT p.order_id,c.customer_name,t.goods_total
FROM paid_orders p JOIN order_totals t ON t.order_id=p.order_id
JOIN c31_customers c ON c.customer_id=p.customer_id
ORDER BY p.order_id;
| 주문 | 고객 | 상품 금액 |
|---|---|---|
| 101 | 김민수 | 11500.00 |
| 102 | 김민수 | 8000.00 |
| 103 | 이서연 | 19500.00 |
WITH는 문장 앞에 한 번 쓰고 여러 이름은 쉼표로 나눕니다. 각 이름의 AS 괄호 안에는 SELECT를 넣고 그 뒤에 최종 SELECT를 이어 씁니다. 중간 CTE 뒤에 세미콜론을 넣으면 문장이 끝나므로 이후 조회에서 이름을 찾지 못하게 됩니다.
각 단계의 결과를 따로 검증하기
최종 합계가 다르면 CTE 안의 SELECT를 먼저 단독으로 실행해 보세요. paid_orders의 주문 번호가 101·102·103인지, order_totals의 주문 104까지 포함한 네 합계가 의도한 것인지 확인한 뒤 연결합니다. 어느 단계에서 취소 주문을 제외하는지도 명시합니다.
WITH paid_orders AS (
 SELECT order_id,customer_id FROM c31_orders WHERE status='paid'
)
SELECT * FROM paid_orders ORDER BY order_id;
최종 조회만 바꾸어 중간 결과를 볼 수도 있습니다. 같은 CTE 정의를 쓰더라도 출력 단위가 주문에서 고객으로 바뀌면 GROUP BY 등 추가 집계가 필요합니다. 이름이 같은 중간 결과를 반복 정의하기보다 실제 범위를 확인합니다.
유효 범위와 성능을 과장하지 않기
CTE 이름은 해당 SQL 문에서만 유효합니다. 다음 문장에서 SELECT * FROM paid_orders를 실행할 수 있는 영구 객체가 아닙니다. 여러 문장에서 재사용할 정의라면 VIEW, 저장된 임시 데이터가 필요하면 임시 테이블 등을 목적에 맞게 검토합니다.
서버는 쿼리 구조와 최적화 조건에 따라 중간 결과를 병합하거나 구체화할 수 있습니다. WITH를 썼으니 반드시 한 번만 계산되거나 언제나 빠르다고 단정하지 않습니다. 가독성 개선과 실행 계획 개선을 나누어 평가하고 실제 EXPLAIN으로 확인합니다. 재귀 CTE는 이 글의 비재귀 단계 분리와 별도의 주제입니다.
이름·열·집계 단위를 점검하고 정리하기
문법 오류는 괄호·쉼표·세미콜론부터 확인하고, 열을 찾지 못하면 CTE의 SELECT 목록에 그 열이 있는지 살펴봅니다. 같은 이름의 원본 테이블과 혼동되지 않는 이름을 쓰고 SELECT *보다 필요한 열을 적습니다. 정리할 영구 CTE 객체는 없으며 이 글에서 만든 원본 실습 테이블만 정리합니다.
반복하기 전 현재 DB와 실제 정의·행을 확인하고 필요한 자료를 백업합니다. 보관할 데이터가 없는 이 글의 전용 실습 객체만 아래 순서로 정리합니다. 외래키가 있으면 자식부터 지웁니다. DROP TABLE은 구조와 데이터를 모두 없애며 일반적인 ROLLBACK으로 복원되지 않으므로 취소 가능한 DML 실습과 분리합니다.
DROP TABLE shopcourse.c31_items;
DROP TABLE shopcourse.c31_orders;
DROP TABLE shopcourse.c31_products;
DROP TABLE shopcourse.c31_customers;
MariaDB 강좌 / 명령줄 클라이언트로 접속하고 SQL 파일 실행하기
터미널 명령과 SQL 입력 위치를 구분하고 학습 계정으로 접속합니다. UTF-8 SQL 파일의 SOURCE 실행, 예상 결과, 오류 중단·한글 표시·경로 문제를 함께 확인합니다.
MariaDB 강좌 / INNER JOIN으로 서로 연결된 데이터 조회하기
고객과 주문을 INNER JOIN으로 연결하고 결과 한 행의 의미를 확인합니다. ON과 WHERE, 테이블 별칭, 일대다로 늘어나는 행과 조건 없는 곱집합을 비교합니다.
MariaDB 강좌 / ORDER BY·LIMIT로 정렬하고 조회 범위 제한하기
ORDER BY의 여러 열·방향과 LIMIT·OFFSET을 같은 가격의 상품으로 실습합니다. 동점 해소, 페이지 경계 변화, 마지막 정렬값을 이용한 조회와 NULL 배치를 설명합니다.
MariaDB 강좌 / 문자열 타입 선택하기: CHAR·VARCHAR·TEXT
CHAR·VARCHAR·TEXT를 저장 목적에 따라 선택하고 문자 수·바이트 수·끝 공백을 비교합니다. 한글과 이모지 입력, 길이 초과 오류, 정렬 규칙과 긴 본문 저장 시 주의점을 설명합니다.
MariaDB 강좌 / ALTER TABLE로 구조 변경하기: 열·제약 조건·변경 전 점검
ALTER TABLE을 새 코드 열 추가·기존 행 채우기·제약 적용으로 나누어 실습합니다. NULL·중복 사전 검사, MODIFY 속성 보존, 실제 실패 입력과 잠금·복구 계획을 설명합니다.
MariaDB 강좌 / 재귀 CTE로 계층 데이터 조회하고 순환 막기
부모·자식 분류 데이터로 재귀 CTE의 앵커, 재귀 단계, 깊이와 경로를 실습합니다. 종료 조건 변경과 순환 데이터 테스트를 통해 잘린 결과와 무한 반복 위험을 구분합니다.
MariaDB 강좌 / 데이터베이스 만들기: CREATE DATABASE·USE·문자 집합
shopcourse 데이터베이스를 만들고 현재 연결의 작업 대상으로 선택합니다. utf8mb4와 collation, 기존 DB에서 IF NOT EXISTS의 한계, 권한·문자 설정 확인을 예제로 설명합니다.
MariaDB 강좌 / 중복 데이터를 줄이는 정규화와 주문 데이터베이스 설계
주문 상세에 반복한 고객 정보의 변경 오류를 관찰하고 키별 사실을 네 테이블로 나눕니다. 부분·이행 종속, 거래 당시 단가와 스냅샷 보존, 무결성 제약과 성능의 별도 검토를 설명합니다.
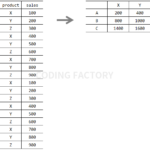
피벗 테이블은 엑셀의 유용한 기능 중의 하나입니다. 예를 들어 아래의 왼쪽 데이터를 오른쪽 표처럼 만드는 것이 피벗 테이블입니다. 조건에 따라 그룹화시켜서 보기 좋게 데이터를 정리하는 것이라 보면 됩니다. MariaDB에서도 몇 가지 함수를 이용하여 피벗 테이블을 만들 수 있습니다.
MariaDB의 논리 연산자에 대하여 알아보겠습니다. 예제로 사용하는 테이블은 아래의 데이터를 가진 T_2이라는 테이블입니다. 각 열의 데이터 형식은 다음과 같습니다. C_1 : 정수 C_2 : 문자 +----+------+------+ | ID | C_1 | C_2 | +----+------+------+ | 1 | 1 | A | | 2 | ...