MariaDB 강좌 / EXPLAIN으로 실행 계획 읽고 인덱스 전후 비교하기
EXPLAIN은 쿼리를 어떻게 실행할지 최적화기가 선택한 계획을 보여 줍니다. 인덱스 전후에 같은 쿼리와 결과를 비교하면서 접근 방식·선택 키·예상 행 수를 읽되, 예상치와 실제 실행 시간은 구분해야 합니다.
실행 계획에서 먼저 볼 항목 정하기
어떤 테이블부터 읽고 어떤 키로 범위를 좁힐지 이해하는 것이 출발점입니다. type이 ALL이라고 무조건 나쁘거나 Using filesort가 나오면 디스크 파일 정렬이 확정되는 것은 아닙니다. 데이터량과 선택 비율, 실제 지연을 함께 봅니다. 후보 키를 정하는 근거는 인덱스 만들기: 단일·복합 인덱스와 열 순서이며, 실제로 느린 쿼리를 찾을 때는 서버 설정·SQL 모드·시간대·로그 확인하기의 로그 기록 조건도 함께 확인합니다.
| 열 | 확인할 내용 | 주의 |
|---|---|---|
| table | 현재 단계의 테이블·별칭 | 한 쿼리에 여러 단계 가능 |
| type | 접근 방식 | 작은 테이블의 ALL은 합리적일 수 있음 |
| possible_keys / key | 후보 / 실제 선택 키 | 인덱스 존재와 선택은 별개 |
| rows | 예상 읽을 행 수 | 정확한 실행 결과 개수 아님 |
| Extra | 필터·정렬·커버링 등 | 문구 하나만으로 성능 판정 금지 |
같은 분포를 재현하는 1000행 준비하기
shopcourse에 접속해 digits_40_lab·explain_40_lab이 없는지 확인합니다. 아래 코드는 숫자 0~9의 세 조합으로 1000행을 만들며 실제 주문 자료를 읽거나 변경하지 않습니다. 고객 번호는 1~100에 나누어 고객 한 명당 10행이 생깁니다.
USE shopcourse;
CREATE TABLE digits_40_lab(n TINYINT PRIMARY KEY) ENGINE=InnoDB;
INSERT INTO digits_40_lab VALUES(0),(1),(2),(3),(4),(5),(6),(7),(8),(9);
CREATE TABLE explain_40_lab(
 order_id INT PRIMARY KEY,customer_id INT NOT NULL,
 ordered_at DATETIME NOT NULL,amount DECIMAL(10,2) NOT NULL
) ENGINE=InnoDB;
INSERT INTO explain_40_lab
SELECT 1+a.n+10*b.n+100*d.n,
 MOD(a.n+10*b.n+100*d.n,100)+1,
 DATE_ADD('2026-01-01',INTERVAL (a.n+10*b.n+100*d.n) MINUTE),1000
FROM digits_40_lab a CROSS JOIN digits_40_lab b CROSS JOIN digits_40_lab d;
0~999의 번호 계산과 입력 행 수를 확인하려면 SELECT COUNT(*) FROM explain_40_lab;를 실행합니다. 이 인공 분포는 계획 읽기 연습용이며 운영 고객의 편중이나 데이터 크기를 대신하지 않습니다.
인덱스 전후에 같은 EXPLAIN 실행하기
EXPLAIN SELECT order_id,ordered_at FROM explain_40_lab
WHERE customer_id=47 AND ordered_at>='2026-01-01'
ORDER BY ordered_at,order_id;
CREATE INDEX idx_e40_customer_date
ON explain_40_lab(customer_id,ordered_at,order_id);
EXPLAIN SELECT order_id,ordered_at FROM explain_40_lab
WHERE customer_id=47 AND ordered_at>='2026-01-01'
ORDER BY ordered_at,order_id;
첫 계획에서는 보조 키 없이 읽고, 이후에는 고객·시간 키를 사용할 후보가 생깁니다. 실제 key가 무엇인지와 rows가 어떻게 바뀌었는지 자신의 출력으로 비교합니다. 버전·통계에 따라 출력 세부 값은 다를 수 있으므로 특정 숫자를 그대로 외우지 않습니다. EXPLAIN 공식 항목 설명을 참고하세요.
이 글의 1000행 생성 코드를 MariaDB 12.3.3에서 실행했을 때 관찰한 한 번의 계획은 다음과 같습니다. 자신의 출력이 같은 숫자여야 한다는 뜻은 아니며 데이터·통계·버전에 따라 달라질 수 있습니다.
| 시점 | type | key | rows | Extra |
|---|---|---|---|---|
| 인덱스 전 | ALL | NULL | 1000 | Using where; Using filesort |
| 인덱스 후 | range | idx_e40_customer_date | 10 | Using where; Using index |
이 관찰에서는 전체 스캔 후보가 고객·시각 범위 접근으로 바뀌고 예상 읽기 규모가 1000에서 10으로 줄었습니다. 이것은 실행 시간이 100배 빨라졌다는 측정이 아닙니다. 결과 주문 열 개가 보존되는지와 실제 실행 정보를 별도로 확인합니다.
계획의 예상과 실제 반환 행을 나누어 검증하기
SELECT order_id,ordered_at FROM explain_40_lab
WHERE customer_id=47 AND ordered_at>='2026-01-01'
ORDER BY ordered_at,order_id;
반환 주문 번호는 47부터 시작해 100씩 증가한 10개입니다. 같은 SELECT가 인덱스 추가 전후에 같은 행을 같은 순서로 반환해야 합니다. EXPLAIN의 rows는 반환 행 수가 아니라 해당 단계의 예상 읽기 규모이므로 COUNT(*)와 다른 값을 보일 수 있습니다.
계획만으로 지연 시간을 보장하지 않습니다. 실제 비교에서는 동일 조건·데이터·동시 부하와 캐시 상태를 통제하고 여러 번 측정합니다. 작은 실습의 시간 차이를 실제 서비스의 개선 비율로 발표하지 않습니다.
ANALYZE와 통계 갱신의 의미 구분하기
MariaDB의 ANALYZE 문장 계열은 쿼리를 실제로 실행해 실행 정보를 얻습니다. EXPLAIN과 같은 읽기 전용 계획 보기라고 생각하고 UPDATE·DELETE 앞에 붙이면 안 됩니다. 필요한 경우 별도 환경에서 SELECT만 대상으로 적용 범위와 권한을 확인합니다.
ANALYZE TABLE은 테이블 통계를 갱신하는 다른 기능입니다. 통계가 오래되면 최적화기의 추정이 부정확해질 수 있지만, 통계 갱신도 서버 부하·잠금과 버전 차이를 검토해야 합니다. FORCE INDEX로 원하는 계획을 강제로 만들기 전에 데이터 분포와 쿼리 형태를 먼저 조사합니다.
실제 실행 정보가 필요하면 이 학습용 SELECT만 대상으로 다음처럼 확인할 수 있습니다. ANALYZE FORMAT=JSON은 쿼리를 실행하며 r_rows·r_loops 등 실제 측정 필드와 rows 추정값을 구분해서 읽습니다. 실행 시간은 환경마다 달라 고정된 정답 숫자를 두지 않습니다.
ANALYZE FORMAT=JSON
SELECT order_id,ordered_at FROM explain_40_lab
WHERE customer_id=47 AND ordered_at>='2026-01-01'
ORDER BY ordered_at,order_id;
검증 기록과 실습 객체 정리하기
서버 버전, CREATE TABLE·인덱스 정의, 데이터 생성 방법, 비교한 SELECT와 전후 계획을 함께 보관하면 결과를 재현하기 쉽습니다. 이 글의 실습 테이블 두 개만 보관 필요성을 확인하고 삭제합니다. 두 객체에는 외래키가 없으며 기존 주문 테이블은 정리 대상이 아닙니다.
DROP TABLE shopcourse.explain_40_lab;
DROP TABLE shopcourse.digits_40_lab;
MariaDB / Query / LEFT JOIN, RIGHT JOIN, INNER JOIN
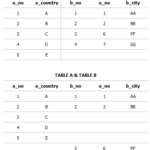
SQL의 JOIN은 여러 테이블을 한 번에 나타낼 때 사용합니다. 대표적인 JOIN 방식은 LEFT JOIN, RIGHT JOIN, INNER JOIN이 있습니다. 다음은 세 가지 JOIN의 차이를 알아보기 위한 간단한 예제 테이블입니다.
MariaDB 강좌 / 날짜와 시간 저장하기: DATE·DATETIME·TIMESTAMP
DATE·DATETIME·TIMESTAMP의 저장 의미와 시간대 처리를 비교합니다. 동일 입력의 한국 시간·UTC 조회 결과, 버전별 TIMESTAMP 범위, 날짜 오류와 설정 복원을 실습합니다.
MariaDB 강좌 / 서버 설정·SQL 모드·시간대·로그 확인하기
설정 파일·GLOBAL·SESSION의 차이를 기준으로 MariaDB 동작을 확인합니다. SQL 모드 오류와 TIMESTAMP·DATETIME 시간대 실습, 로그 조건 점검 및 변경 복구 절차를 제공합니다.
VIEW는 가상의 테이블입니다. 실제로 데이터를 저장하지 않고, 기존의 하나 이상의 테이블을 기반으로 한 쿼리 결과를 테이블처럼 사용할 수 있게 해줍니다. 뷰는 복잡한 쿼리를 단순화하고, 보안 및 데이터 관리에 유용하게 사용됩니다.
MariaDB 강좌 / 테이블 관계 설계하기: 일대다·다대다·외래키
고객·상품·주문·상세 네 테이블로 일대다와 다대다 관계를 설계합니다. 복합키·주문 당시 단가·외래키 실패 입력과 삭제 제한을 실행하고 업무상 삭제 정책을 구분합니다.
MariaDB 강좌 / 윈도 함수로 누적 합계와 이전·다음 행 비교하기
누적 합계와 LAG·LEAD를 계산하고 동점 데이터로 ROWS·RANGE를 비교합니다. 날짜 필터를 누적 전후에 적용한 결과와 정렬·기간 경계를 확인합니다.
MariaDB 강좌 / Ubuntu에 MariaDB 설치하고 서버 실행하기
Ubuntu APT 설치 후 서버 실행·자동 시작·관리자 소켓 인증을 확인합니다. 로컬 TCP 학습 계정을 만들고 패키지 버전, 인증 오류와 서비스 로그를 확인하는 절차를 설명합니다.
MariaDB 강좌 / 트랜잭션 시작하기: InnoDB·COMMIT·ROLLBACK
InnoDB에서 같은 변경을 ROLLBACK과 COMMIT으로 끝내어 미확정·확정의 차이를 비교합니다. 연결 유지, 영향 행 수 검사, 오류 처리와 구조 변경·외부 작업의 취소 한계를 설명합니다.
MariaDB 강좌 / CSV 가져오기·내보내기: 경로·권한·문자 인코딩
CSV를 문자형 stage에 적재해 형식·중복·경고를 확인한 뒤 실제 타입으로 옮깁니다. LOCAL의 클라이언트 경로, 서버 OUTFILE의 권한·경로, 쉼표·한글·줄바꿈과 왕복 검증을 설명합니다.
MariaDB 강좌 / UNION·UNION ALL로 조회 결과 합치기
UNION과 UNION ALL을 겹치는 서울 고객·결제 고객 목록으로 비교합니다. 출처 열이 중복 기준을 바꾸는 이유, 열 위치·타입·전체 정렬의 조건을 설명합니다.