MariaDB 강좌 / 복제 구조와 지연·오류·장애 대응 이해하기
MariaDB의 일반적인 비동기 복제는 원본 서버의 변경 기록을 복제본으로 전달하고 적용하는 구조입니다. 복제본이 존재한다고 최신 데이터가 모두 반영되거나 장애 시 자동 승격되는 것은 아니며, 지연·오류·데이터 손실 가능성과 쓰기 경로를 함께 관리해야 합니다.
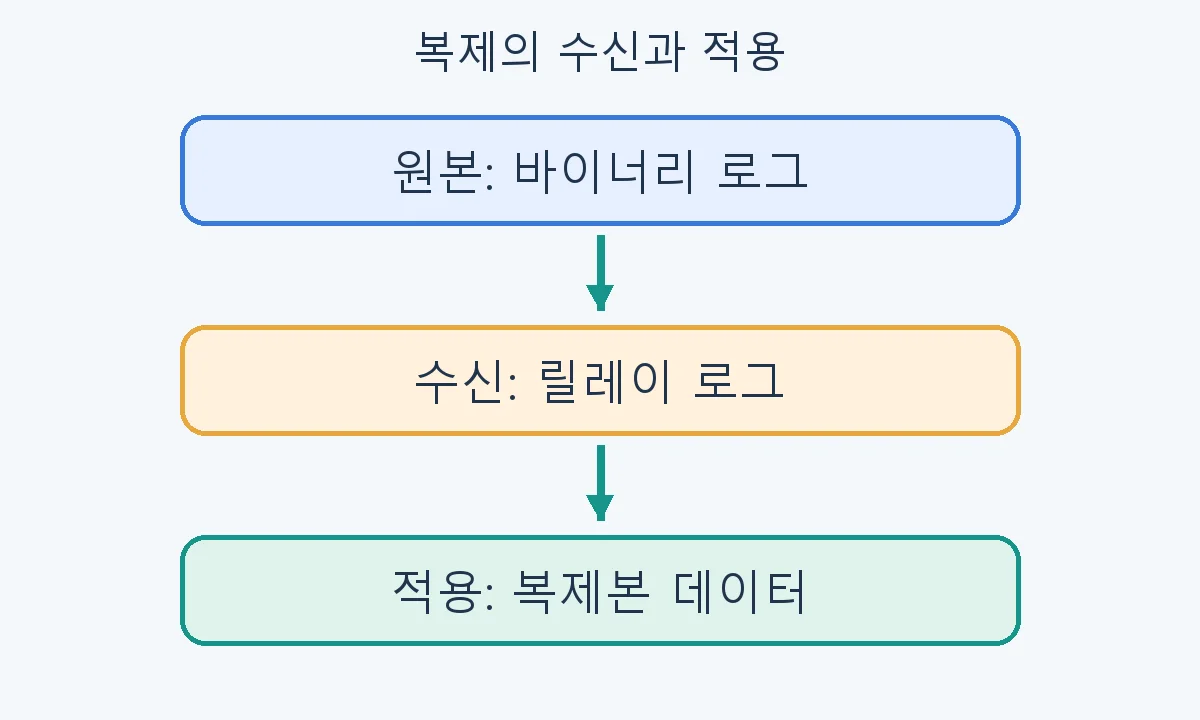
원본의 변경이 복제본에 도착하는 과정
원본(primary)은 변경 기록을 바이너리 로그에 남기고, 복제본(replica)의 수신 스레드는 그 기록을 받아 릴레이 로그에 저장합니다. 적용 스레드는 받은 기록을 복제본 데이터에 반영합니다. 병렬 복제에서는 적용 작업자가 여러 개일 수도 있지만, 기록을 받는 단계와 적용하는 단계를 구분한다는 원칙은 같습니다.
원본에서 COMMIT이 성공해도 비동기 복제본의 적용이 그 순간 끝났다는 뜻은 아닙니다. 원본에 쓴 직후 복제본에서 읽으면 방금 쓴 값이 아직 보이지 않을 수 있습니다. 쓰기 후 즉시 일관된 읽기가 필요한 요청을 어느 서버로 보낼지 애플리케이션 정책이 필요합니다. 복제 구성의 전제 조건과 MariaDB GTID 설명에서 로그와 위치 관리의 역할을 확인할 수 있습니다.
GTID(Global Transaction ID, 전역 트랜잭션 식별자)는 복제 위치를 식별하는 데 사용합니다. GTID가 있다고 데이터가 자동으로 검증되거나 어느 복제본이든 바로 승격 가능한 것은 아닙니다. MariaDB와 MySQL의 GTID를 이름이 같다는 이유로 동일한 구문·동작으로 간주하지 않습니다.
구성 정보를 먼저 확인하고 진단 권한을 준비하기
다음 조회는 이미 구성된 원본과 복제본을 진단하는 예제입니다. 복제 구성 자체에는 서로 다른 server_id, 원본의 바이너리 로그, 복제 계정과 통신 경로, 일관된 초기 데이터 복사가 필요합니다. 운영 데이터가 있는 복제본에 연결 정보만 지정한다고 올바른 초기 상태가 만들어지지는 않습니다.
원격 통신에서는 TLS와 접속 원본 제한, 계정 최소 권한을 함께 구성합니다. 상태 조회에는 서버 버전에 맞는 REPLICA MONITOR 등의 권한이 필요하며, 복제 스레드를 제어하는 권한과는 다릅니다. 읽기 진단을 위해 애플리케이션에 전체 관리자 권한을 줄 필요는 없습니다.
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
위 조회는 원본에서 실행합니다. server_id가 실제 구성과 맞고 binary_logging이 활성화되었는지 확인한 뒤 현재 로그 위치를 기록합니다. 아래 조회는 복제본에서 실행합니다. \G는 mariadb 명령줄 클라이언트에서 결과를 세로로 표시하는 구분자이며 SQL API에 그대로 보내는 문자가 아닙니다.
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
이 글의 전달·지연 실습은 서로 다른 ID와 ROW 바이너리 로그, GTID를 사용하는 임시 MariaDB 12.3.3 서버 두 개에서 확인했습니다. 실제 원격망의 TLS 배포나 운영 장애 승격을 수행한 결과를 의미하지는 않습니다.
상태 한 항목이 아니라 조합을 읽기
| 항목 | 읽는 방법 |
|---|---|
| Slave_IO_Running | 수신 단계의 동작 상태. Yes만으로 적용 완료를 보장하지 않음 |
| Slave_SQL_Running | 적용 단계의 동작 상태. 중지 시 SQL 오류와 의도적인 정지 여부 확인 |
| Last_IO_Error · Last_SQL_Error | 통신·인증 오류와 데이터 적용 오류를 구분할 단서 |
| Seconds_Behind_Master | 시점과 상태에 따른 지연 지표. 0이나 NULL을 단독 정상 판정으로 사용하지 않음 |
| Gtid_IO_Pos · @@GLOBAL.gtid_slave_pos | 받은 위치와 적용 위치를 구분하여 비교할 자료. 구성과 도메인을 함께 해석 |
SHOW REPLICA STATUS라는 명령을 사용해도 반환 열에 Slave·Master라는 기존 이름이 남을 수 있습니다. 버전마다 열 순서도 달라질 수 있으므로 자동화는 열 이름으로 읽습니다. SHOW REPLICA STATUS 문서가 상태와 권한을 설명합니다.
두 스레드가 Yes인 것, 특정 업무 쓰기가 반영된 것, 장애 시 감수할 수 있는 손실 범위는 서로 다른 질문입니다. 상태와 로그 위치를 기록하고, 필요한 업무 데이터나 마지막 처리 식별자를 대조해야 합니다. 지연 수치가 작아도 복제 필터나 원치 않는 쓰기로 데이터 차이가 있을 수 있습니다.
분리된 실습 환경에서 적용 중지와 재개 관찰하기
아래 단계는 빈 데이터로 만든 별도의 복제 실습 환경과 해당 스레드 관리 권한이 있을 때만 수행합니다. 기존 운영 복제본을 멈추는 진단 절차가 아닙니다. 먼저 원본에서 다음 SQL을 실행하고 복제본에서도 marker 행이 도착했는지 확인하세요.
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
그다음 복제본에서 적용 스레드만 멈춥니다. 수신은 계속될 수 있으므로 로그를 받는 것과 데이터를 바꾸는 것의 차이를 관찰할 수 있습니다.
STOP REPLICA SQL_THREAD;
원본에서 아래 행을 추가합니다. 정지한 복제본에서는 아직 두 번째 행이 보이지 않아야 합니다. 상태를 조회하면 수신·적용 단계의 차이도 확인할 수 있습니다.
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');
관찰 직후 복제본에서 다음 명령으로 적용을 재개하고 probe를 다시 조회합니다. 설정한 복제 필터와 오류가 없다면 두 번째 행도 도착해야 합니다. 이미 중지해 둔 다른 운영 작업이 있는 환경에서 명령만 복사해 재개하지 마세요.
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
적용에는 시간이 걸릴 수 있으므로 한 번의 SELECT에서 즉시 안 보인다고 실패로 단정하지 않습니다. 반대로 무한히 기다리지 말고 상태와 마지막 오류를 확인합니다. 실습 후 복제본 스레드가 원래 실행 상태로 돌아왔는지 확인하고, 임시 probe 테이블의 정리는 원본에서 수행하여 복제본에 반영되는지도 확인합니다.
오류가 났을 때 지우거나 건너뛰기 전에 할 일
| 문제 | 우선 확인 | 피해야 할 성급한 처리 |
|---|---|---|
| 수신 연결 실패 | 주소·포트·DNS·방화벽·TLS·복제 계정과 마지막 IO 오류 | 인증·암호화 설정을 무조건 끄기 |
| 적용 스레드 정지 | 중복 키·없는 행·스키마 차이·필터와 마지막 SQL 오류 | 원인을 확인하지 않고 이벤트를 건너뛰기 |
| 로그를 더 이상 받을 수 없음 | 원본 로그 보존 범위와 복제 위치, 초기 복사 시점 | 일관된 초기 데이터 없이 위치만 강제 변경 |
| 지연이 증가함 | 원본 쓰기량, 복제본 IO·CPU, 큰 트랜잭션·잠금 | 지연 숫자 하나만 보고 즉시 승격 |
문제 시각의 상태와 오류를 먼저 보존하고, 데이터 차이가 생겼다면 일관된 백업에서 복제본을 다시 만드는 방법까지 검토합니다. 복제 이벤트를 임의로 건너뛰면 스레드는 다시 돌아도 누락된 데이터가 남을 수 있습니다. 복제는 잘못된 DELETE도 전달할 수 있으므로 별도 백업과 복원 검증을 대신하지 않습니다.
장애 승격은 쓰기 경로를 통제하는 절차로 이해하기
- 장애 상태와 원본에 접근 가능한 범위를 확인하고, 기존 원본으로 새 쓰기가 들어가지 못하도록 격리합니다. 네트워크 단절만으로 원본이 확실히 멈췄다고 가정하지 않습니다.
- 후보 복제본의 수신·적용 위치, 미적용 기록과 오류를 확인하고 손실 가능 범위를 판단합니다.
- 업무의 복구 시점 목표(RPO: 허용 가능한 데이터 손실)와 복구 시간 목표(RTO: 허용 가능한 복구 시간)에 맞춰 승격 여부를 결정합니다.
- 정해진 승격·연결 전환 절차로 단일 쓰기 경로를 만들고 애플리케이션의 읽기·쓰기를 검증합니다.
- 복구된 이전 원본은 최신 상태와 일관성을 검증하고 필요하면 다시 복제본으로 구성한 뒤 편입합니다.
read_only는 일반 계정의 실수로 인한 복제본 쓰기를 제한하는 장치이며 모든 권한의 모든 쓰기를 절대 차단하지는 않습니다. 읽기 전용 복제본의 예외 권한을 확인하세요. 단순히 read_only를 끄는 것이 승격 절차 전체는 아닙니다. 원본과 복제본이 동시에 쓰기를 받는 분할 뇌(split brain)를 막으려면 이전 원본 격리와 연결 라우팅을 함께 통제해야 합니다.
MariaDB 강좌 / 명령줄 클라이언트로 접속하고 SQL 파일 실행하기
터미널 명령과 SQL 입력 위치를 구분하고 학습 계정으로 접속합니다. UTF-8 SQL 파일의 SOURCE 실행, 예상 결과, 오류 중단·한글 표시·경로 문제를 함께 확인합니다.
MariaDB 강좌 / WHERE로 조건 지정하기: 비교·AND·OR·IN·BETWEEN·LIKE
상품 가격·분류·재고·이름으로 WHERE 조건을 실습합니다. AND·OR 괄호 차이, IN 목록, BETWEEN 경계, LIKE 와일드카드와 실제 퍼센트 검색을 예상 행 번호로 확인합니다.
MariaDB 강좌 / LEFT JOIN으로 연결되지 않은 행도 조회하기
LEFT JOIN으로 주문 없는 고객을 유지하고 paid 주문 수를 0까지 표시합니다. ON·WHERE의 필터 위치, COUNT(*)의 함정, NULL 기본키로 미일치 행을 찾는 기준을 실습합니다.
MariaDB 강좌 / NULL·기본값·NOT NULL·CHECK로 입력 조건 정하기
NULL·빈 문자열·0·입력 생략을 구분하고 DEFAULT·NOT NULL·CHECK의 역할을 실습합니다. nullable 열의 CHECK 예외, 실패 입력, 제약 이름과 설정 복원 방법을 설명합니다.
MariaDB / 데이터베이스 저장 위치 변경하는 방법
MariaDB의 버전이 12.1이라고 할 때, 윈도우용 MariaDB의 기본 설치 위치는 C:\Program Files\MariaDB 12.1, 데이터베이스 저장 위치는 C:\Program Files\MariaDB 12.1\data입니다. 데이터베이스 저장 위치를 다음으로 변경해보겠습니다. D:\Database\MariaDB\data
MariaDB 강좌 / UNION·UNION ALL로 조회 결과 합치기
UNION과 UNION ALL을 겹치는 서울 고객·결제 고객 목록으로 비교합니다. 출처 열이 중복 기준을 바꾸는 이유, 열 위치·타입·전체 정렬의 조건을 설명합니다.
MariaDB 강좌 / SELECT로 열 선택하기: 별칭·계산식·DISTINCT
SELECT의 열 선택과 AS 별칭, 행별 계산식, DISTINCT의 열 조합 기준을 실습합니다. 원본 데이터와 출력 결과를 구분하고 WHERE에서 별칭을 사용할 때의 주의점을 설명합니다.
MariaDB 강좌 / ALTER TABLE로 구조 변경하기: 열·제약 조건·변경 전 점검
ALTER TABLE을 새 코드 열 추가·기존 행 채우기·제약 적용으로 나누어 실습합니다. NULL·중복 사전 검사, MODIFY 속성 보존, 실제 실패 입력과 잠금·복구 계획을 설명합니다.
MariaDB 강좌 / WITH로 공통 테이블 식 만들고 쿼리 나누기
WITH의 공통 테이블 식으로 결제 주문·주문별 합계·고객 연결을 단계별로 나눕니다. 중간 결과 검증, 한 문장 안의 유효 범위와 성능을 자동 보장하지 않는 이유를 설명합니다.
MariaDB 강좌 / 윈도 함수로 누적 합계와 이전·다음 행 비교하기
주문별 금액을 누적하고 LAG·LEAD로 이전·다음 행을 비교합니다. ROWS 프레임, 날짜 동점, 결측값과 필터 위치에 따라 누적 지표가 달라지는 조건을 설명합니다.