MariaDB 강좌 / 복제 구조와 지연·오류·장애 대응 이해하기
MariaDB의 일반적인 비동기 복제는 원본 서버의 변경 기록을 복제본으로 전달하고 적용하는 구조입니다. 복제본이 존재한다고 최신 데이터가 모두 반영되거나 장애 시 자동 승격되는 것은 아니며, 지연·오류·데이터 손실 가능성과 쓰기 경로를 함께 관리해야 합니다.
원본의 변경이 복제본에 도착하는 과정
원본(primary)은 변경 기록을 바이너리 로그에 남기고, 복제본(replica)의 수신 스레드는 그 기록을 받아 릴레이 로그에 저장합니다. 적용 스레드는 받은 기록을 복제본 데이터에 반영합니다. 병렬 복제에서는 적용 작업자가 여러 개일 수도 있지만, 기록을 받는 단계와 적용하는 단계를 구분한다는 원칙은 같습니다. 복제가 손상된 변경까지 전달할 수 있으므로 mariadb-dump로 데이터베이스 백업하기와 백업을 별도 데이터베이스에 복원하고 검증하기의 별도 복구 검증이 필요합니다. 새 로컬 컨테이너 준비는 Docker로 MariaDB 실습 환경 만들기의 파일·볼륨 구분을 바탕으로 합니다.
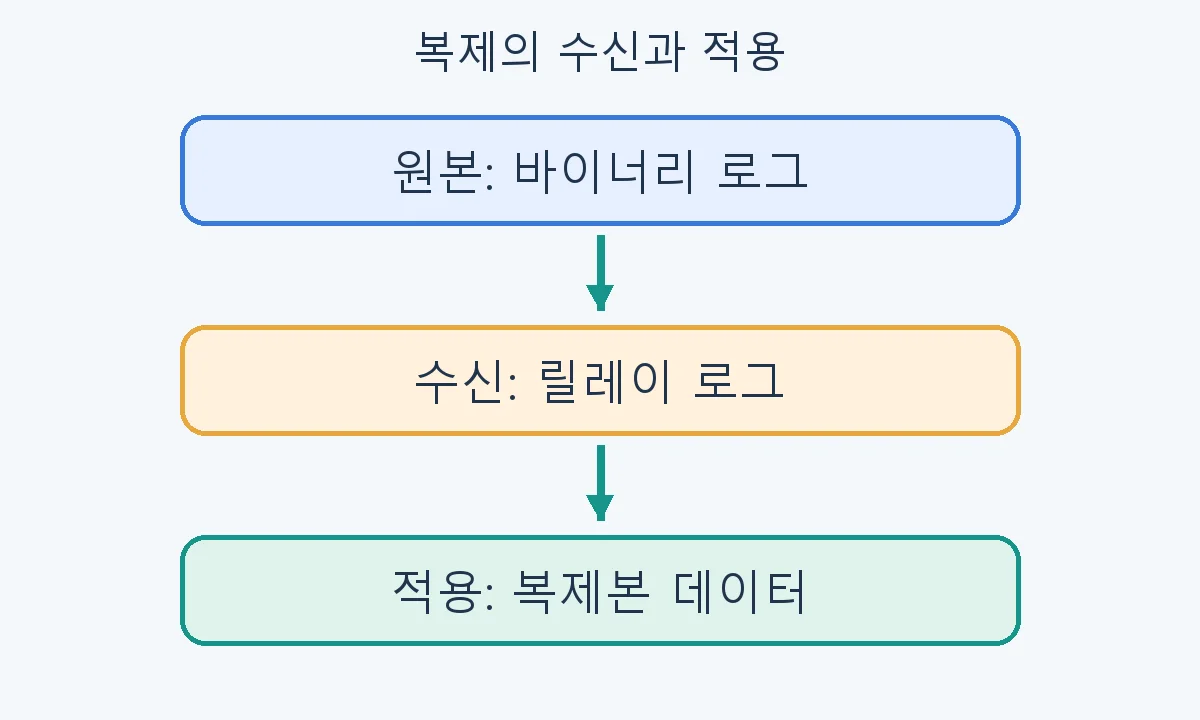
원본에서 COMMIT이 성공해도 비동기 복제본의 적용이 그 순간 끝났다는 뜻은 아닙니다. 원본에 쓴 직후 복제본에서 읽으면 방금 쓴 값이 아직 보이지 않을 수 있습니다. 쓰기 후 즉시 일관된 읽기가 필요한 요청을 어느 서버로 보낼지 애플리케이션 정책이 필요합니다. 복제 구성의 전제 조건과 MariaDB GTID 설명에서 로그와 위치 관리의 역할을 확인할 수 있습니다.
GTID(Global Transaction ID, 전역 트랜잭션 식별자)는 복제 위치를 식별하는 데 사용합니다. GTID가 있다고 데이터가 자동으로 검증되거나 어느 복제본이든 바로 승격 가능한 것은 아닙니다. MariaDB와 MySQL의 GTID를 이름이 같다는 이유로 동일한 구문·동작으로 간주하지 않습니다.
처음 실습한다면 빈 두 서버를 준비하기
이미 정상 구성된 학습용 복제가 있다면 이 절은 건너뜁니다. 다음은 기본 Docker 강좌의 secrets 파일 방식을 확장한 별도 로컬 실습 구성입니다. 기존 데이터가 없는 새 프로젝트와 새 볼륨에서만 시작하며, 운영 서버나 이전 복제본의 초기화 절차가 아닙니다.
새 폴더에 secrets/primary-root.txt와 secrets/replica-root.txt를 만들고 서로 다른 root 암호 한 줄을 저장합니다. secrets/는 .gitignore에 넣습니다. 아래 내용을 compose.yaml로 저장합니다. 호스트 포트는 공개하지 않으며 두 서버는 내부 Compose 네트워크에서만 연결됩니다.
name: mariadb-replication-lab
services:
  primary:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/primary_root
    secrets: [primary_root]
    command: ["--server-id=11", "--log-bin=primary-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON"]
    volumes: [primary_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
  replica:
    image: mariadb:11.8
    environment:
      MARIADB_ROOT_PASSWORD_FILE: /run/secrets/replica_root
    secrets: [replica_root]
    command: ["--server-id=12", "--log-bin=replica-bin", "--binlog-format=ROW", "--gtid-strict-mode=ON", "--read-only=ON"]
    volumes: [replica_data:/var/lib/mysql]
    networks: [replication]
    healthcheck:
      test: ["CMD", "healthcheck.sh", "--connect", "--innodb_initialized"]
      interval: 10s
      retries: 10
      start_period: 30s
secrets:
  primary_root:
    file: ./secrets/primary-root.txt
  replica_root:
    file: ./secrets/replica-root.txt
volumes:
  primary_data:
  replica_data:
networks:
  replication:
    internal: true
docker compose config --quiet
docker compose up -d
docker compose ps
두 서비스가 healthy인지 확인한 뒤 애플리케이션 데이터 입력 전에 복제 계정을 만듭니다. 아래 명령은 primary의 로컬 관리 클라이언트를 엽니다. 파일에 넣은 primary root 암호를 입력하세요.
docker compose exec primary mariadb -u root -p
CREATE USER 'repl_lab'@'%' IDENTIFIED BY 'Replace_With_A_Unique_Replication_Password';
GRANT REPLICATION SLAVE ON *.* TO 'repl_lab'@'%';
SHOW GRANTS FOR 'repl_lab'@'%';
EXIT;
예제 암호는 새 값으로 바꿉니다. %는 출발지 매칭이며 관리자 권한을 뜻하지 않습니다. 이 계정은 포트를 공개하지 않는 전용 내부 네트워크에서 복제만 허용한 예로, 실제 원격 구성에서는 정확한 출발지와 TLS 정책을 적용합니다.
docker compose exec replica mariadb -u root -p
replica root 암호로 연결한 뒤 방금 정한 복제 암호를 다음 문장에 넣습니다. 비밀번호가 있는 명령이나 출력은 공개하지 않습니다.
CHANGE MASTER TO
  MASTER_HOST='primary', MASTER_PORT=3306,
  MASTER_USER='repl_lab',
  MASTER_PASSWORD='Replace_With_A_Unique_Replication_Password',
  MASTER_USE_GTID=slave_pos;
START REPLICA;
SHOW REPLICA STATUS\G
이 절은 둘 다 빈 새 서버이고 원본 로그가 남아 있는 경우에만 적용합니다. 데이터가 이미 있거나 필요한 로그가 없는 서버는 일관된 백업·복원과 복제 위치 설정을 먼저 수행해야 하며, 연결 정보만 지정해서 맞출 수 없습니다. 두 스레드가 Yes인지 확인한 뒤 아래 진단·marker 실습을 이어갑니다.
Compose 설정은 정적으로 검토한 구성입니다. 이 작업 환경에는 Docker가 없어 해당 이미지 시작·네트워크·볼륨 동작을 실행해 확인한 예제로 표시하지 않습니다. 실제 네이티브 두 서버에서 확인한 복제 실습 범위와 구분하세요.
구성 정보를 먼저 확인하고 진단 권한을 준비하기
다음 조회는 이미 구성된 원본과 복제본을 진단하는 예제입니다. 복제 구성 자체에는 서로 다른 server_id, 원본의 바이너리 로그, 복제 계정과 통신 경로, 일관된 초기 데이터 복사가 필요합니다. 운영 데이터가 있는 복제본에 연결 정보만 지정한다고 올바른 초기 상태가 만들어지지는 않습니다.
원격 통신에서는 TLS와 접속 원본 제한, 계정 최소 권한을 함께 구성합니다. 상태 조회에는 서버 버전에 맞는 REPLICA MONITOR 등의 권한이 필요하며, 복제 스레드를 제어하는 권한과는 다릅니다. 읽기 진단을 위해 애플리케이션에 전체 관리자 권한을 줄 필요는 없습니다.
SELECT @@server_id AS server_id, @@log_bin AS binary_logging,
       @@GLOBAL.gtid_binlog_pos AS logged_gtid;
SHOW MASTER STATUS;
위 조회는 원본에서 실행합니다. server_id가 실제 구성과 맞고 binary_logging이 활성화되었는지 확인한 뒤 현재 로그 위치를 기록합니다. 아래 조회는 복제본에서 실행합니다. \G는 mariadb 명령줄 클라이언트에서 결과를 세로로 표시하는 구분자이며 SQL API에 그대로 보내는 문자가 아닙니다.
SELECT @@server_id AS server_id, @@GLOBAL.read_only AS read_only,
       @@GLOBAL.gtid_slave_pos AS applied_gtid;
SHOW REPLICA STATUS\G
이 글의 전달·지연 실습은 서로 다른 ID와 ROW 바이너리 로그, GTID를 사용하는 임시 MariaDB 12.3.3 서버 두 개에서 확인했습니다. 실제 원격망의 TLS 배포나 운영 장애 승격을 수행한 결과를 의미하지는 않습니다.
상태 한 항목이 아니라 조합을 읽기
| 항목 | 읽는 방법 |
|---|---|
| Slave_IO_Running | 수신 단계의 동작 상태. Yes만으로 적용 완료를 보장하지 않음 |
| Slave_SQL_Running | 적용 단계의 동작 상태. 중지 시 SQL 오류와 의도적인 정지 여부 확인 |
| Last_IO_Error · Last_SQL_Error | 통신·인증 오류와 데이터 적용 오류를 구분할 단서 |
| Seconds_Behind_Master | 시점과 상태에 따른 지연 지표. 0이나 NULL을 단독 정상 판정으로 사용하지 않음 |
| Gtid_IO_Pos · @@GLOBAL.gtid_slave_pos | 받은 위치와 적용 위치를 구분하여 비교할 자료. 구성과 도메인을 함께 해석 |
SHOW REPLICA STATUS라는 명령을 사용해도 반환 열에 Slave·Master라는 기존 이름이 남을 수 있습니다. 버전마다 열 순서도 달라질 수 있으므로 자동화는 열 이름으로 읽습니다. SHOW REPLICA STATUS 문서가 상태와 권한을 설명합니다.
두 스레드가 Yes인 것, 특정 업무 쓰기가 반영된 것, 장애 시 감수할 수 있는 손실 범위는 서로 다른 질문입니다. 상태와 로그 위치를 기록하고, 필요한 업무 데이터나 마지막 처리 식별자를 대조해야 합니다. 지연 수치가 작아도 복제 필터나 원치 않는 쓰기로 데이터 차이가 있을 수 있습니다.
분리된 실습 환경에서 적용 중지와 재개 관찰하기
아래 단계는 빈 데이터로 만든 별도의 복제 실습 환경과 해당 스레드 관리 권한이 있을 때만 수행합니다. 기존 운영 복제본을 멈추는 진단 절차가 아닙니다. 먼저 원본에서 다음 SQL을 실행하고 복제본에서도 marker 행이 도착했는지 확인하세요.
CREATE DATABASE IF NOT EXISTS replication_lab;
CREATE TABLE replication_lab.probe (
  probe_id INT PRIMARY KEY,
  marker VARCHAR(40) NOT NULL
) ENGINE=InnoDB;
INSERT INTO replication_lab.probe VALUES (1, 'before-pause');
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
그다음 복제본에서 적용 스레드만 멈춥니다. 수신은 계속될 수 있으므로 로그를 받는 것과 데이터를 바꾸는 것의 차이를 관찰할 수 있습니다.
STOP REPLICA SQL_THREAD;
원본에서 아래 행을 추가합니다. 정지한 복제본에서는 아직 두 번째 행이 보이지 않아야 합니다. 상태를 조회하면 수신·적용 단계의 차이도 확인할 수 있습니다.
INSERT INTO replication_lab.probe VALUES (2, 'during-pause');
관찰 직후 복제본에서 다음 명령으로 적용을 재개하고 probe를 다시 조회합니다. 설정한 복제 필터와 오류가 없다면 두 번째 행도 도착해야 합니다. 이미 중지해 둔 다른 운영 작업이 있는 환경에서 명령만 복사해 재개하지 마세요.
START REPLICA SQL_THREAD;
SELECT probe_id, marker FROM replication_lab.probe ORDER BY probe_id;
적용에는 시간이 걸릴 수 있으므로 한 번의 SELECT에서 즉시 안 보인다고 실패로 단정하지 않습니다. 반대로 무한히 기다리지 말고 상태와 마지막 오류를 확인합니다. 실습 후 복제본 스레드가 원래 실행 상태로 돌아왔는지 확인하고, 임시 probe 테이블의 정리는 원본에서 수행하여 복제본에 반영되는지도 확인합니다.
오류가 났을 때 지우거나 건너뛰기 전에 할 일
| 문제 | 우선 확인 | 피해야 할 성급한 처리 |
|---|---|---|
| 수신 연결 실패 | 주소·포트·DNS·방화벽·TLS·복제 계정과 마지막 IO 오류 | 인증·암호화 설정을 무조건 끄기 |
| 적용 스레드 정지 | 중복 키·없는 행·스키마 차이·필터와 마지막 SQL 오류 | 원인을 확인하지 않고 이벤트를 건너뛰기 |
| 로그를 더 이상 받을 수 없음 | 원본 로그 보존 범위와 복제 위치, 초기 복사 시점 | 일관된 초기 데이터 없이 위치만 강제 변경 |
| 지연이 증가함 | 원본 쓰기량, 복제본 IO·CPU, 큰 트랜잭션·잠금 | 지연 숫자 하나만 보고 즉시 승격 |
문제 시각의 상태와 오류를 먼저 보존하고, 데이터 차이가 생겼다면 일관된 백업에서 복제본을 다시 만드는 방법까지 검토합니다. 복제 이벤트를 임의로 건너뛰면 스레드는 다시 돌아도 누락된 데이터가 남을 수 있습니다. 복제는 잘못된 DELETE도 전달할 수 있으므로 별도 백업과 복원 검증을 대신하지 않습니다.
장애 승격은 쓰기 경로를 통제하는 절차로 이해하기
- 장애 상태와 원본에 접근 가능한 범위를 확인하고, 기존 원본으로 새 쓰기가 들어가지 못하도록 격리합니다. 네트워크 단절만으로 원본이 확실히 멈췄다고 가정하지 않습니다.
- 후보 복제본의 수신·적용 위치, 미적용 기록과 오류를 확인하고 손실 가능 범위를 판단합니다.
- 업무의 복구 시점 목표(RPO: 허용 가능한 데이터 손실)와 복구 시간 목표(RTO: 허용 가능한 복구 시간)에 맞춰 승격 여부를 결정합니다.
- 정해진 승격·연결 전환 절차로 단일 쓰기 경로를 만들고 애플리케이션의 읽기·쓰기를 검증합니다.
- 복구된 이전 원본은 최신 상태와 일관성을 검증하고 필요하면 다시 복제본으로 구성한 뒤 편입합니다.
read_only는 일반 계정의 실수로 인한 복제본 쓰기를 제한하는 장치이며 모든 권한의 모든 쓰기를 절대 차단하지는 않습니다. 읽기 전용 복제본의 예외 권한을 확인하세요. 단순히 read_only를 끄는 것이 승격 절차 전체는 아닙니다. 원본과 복제본이 동시에 쓰기를 받는 분할 뇌(split brain)를 막으려면 이전 원본 격리와 연결 라우팅을 함께 통제해야 합니다.
MariaDB 강좌 / 조회 조건·정렬·페이지 나누기를 개선하기
날짜 범위·정렬·키셋 페이지 조회를 같은 주문 데이터로 검증합니다. 함수 조건의 버전별 최적화, 동점 비교 방향, 포함 검색의 의미와 실제 계획·측정 기준을 설명합니다.
MariaDB 강좌 / 백업을 별도 데이터베이스에 복원하고 검증하기
새 원본과 별도 빈 DB를 준비해 덤프를 복원하고 객체·행 수·키·업무 합계를 비교합니다. 파일 안의 DB 전환·삭제 문장, 클라이언트 호환성과 부분 복원 실패의 대응을 설명합니다.
MariaDB 강좌 / 날짜와 시간 저장하기: DATE·DATETIME·TIMESTAMP
DATE·DATETIME·TIMESTAMP의 저장 의미와 시간대 처리를 비교합니다. 동일 입력의 한국 시간·UTC 조회 결과, 버전별 TIMESTAMP 범위, 날짜 오류와 설정 복원을 실습합니다.
MariaDB / 샘플 데이터베이스 employees 설치하는 방법
데이터베이스를 다루는 공부를 할 때 데이터가 들어있는 데이터베이스가 있으면 좋습니다. 데이터베이스를 직접 만드는 방법도 있지만, 공개된 샘플 데이터베이스를 이용하면 편합니다. 예를 들어 SQL Server라면 AdventureWorks라는 샘플 데이터베이스를 마이크로소프트에서 제공합니다. MariaDB라면 employees를 사용하면 됩니다.
MariaDB 강좌 / GROUP BY·HAVING으로 묶고 집계 결과 걸러내기
GROUP BY로 분류별 상품 수·재고·금액을 계산하고 HAVING으로 그룹을 제한합니다. WHERE 적용 시점과 비집계 열·SQL 모드·NULL 그룹의 주의점을 비교 실습으로 설명합니다.
MariaDB 강좌 / Windows에 MariaDB 설치하고 서버 실행하기
Windows MSI 설치에서 서버·클라이언트, 관리자 인증, 서비스와 포트를 설정합니다. SQL 실행을 확인하고 이후 강좌에서 사용할 학습용 계정을 준비하며 시작·접속 오류를 점검합니다.
MariaDB 강좌 / mariadb-dump로 데이터베이스 백업하기
별도 주문 실습 DB를 준비해 mariadb-dump로 새 SQL 백업 파일을 만듭니다. 종료 코드·해시·문자 인코딩, InnoDB 스냅샷과 동시 DDL의 한계, 객체·권한·별도 복원 검증 기준을 설명합니다.
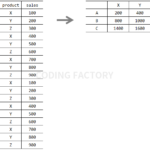
피벗 테이블은 엑셀의 유용한 기능 중의 하나입니다. 예를 들어 아래의 왼쪽 데이터를 오른쪽 표처럼 만드는 것이 피벗 테이블입니다. 조건에 따라 그룹화시켜서 보기 좋게 데이터를 정리하는 것이라 보면 됩니다. MariaDB에서도 몇 가지 함수를 이용하여 피벗 테이블을 만들 수 있습니다.
MariaDB 강좌 / VIEW로 자주 쓰는 조회를 정의하기
CREATE VIEW로 결제 주문 합계를 정의하고 원본 변경·취소가 조회 결과에 반영되는지 확인합니다. CTE와의 차이, INVOKER·DEFINER 권한, 집계 뷰의 수정 제한과 정리 순서를 설명합니다.
MariaDB 강좌 / 복제 구조와 지연·오류·장애 대응 이해하기
빈 두 서버를 준비하는 로컬 Compose 구성과 복제 상태·지연·오류 진단을 설명합니다. 적용 중지·재개를 관찰하고 백업과 장애 승격의 경계를 구분합니다.